lovable.devはかなりアクセスの多いウェブサイトで、月間ユニーク訪問者数は4,200万人以上にのぼります。また、かなり複雑でもあります。400近いルート、自動生成を除いて91万行以上のコードがあり、150以上のエージェントツールをサポートし、シンタックスハイライト付きの小さなIDEまで内蔵しています。現在、このサイトはほかのLovableアプリとまったく同じようにLovable上でホスティングされています。
移行した理由
移行前のlovable.devは、Vercel上でホスティングされたNext.jsアプリでした(もともとは別の場所でホスティングしていましたが、規模が拡大するにつれて、ローカル環境と本番環境のビルド互換性や、一部の地域での読み込み時間の遅さといった問題が出始めました)。Vercelは見事なパフォーマンスを発揮し、移行するとすぐに問題は解消しました。とはいえ、いくつかの理由から、ホスティングをLovableに移行することにしました。
自社製品を使う最大の理由はドッグフーディングです。ユーザーが感じる痛みを自分たちでも感じたいですし、ユーザーのために製品を改善し続けるため、フィードバックループをできるだけ短くしたいと考えています。
また、単一アプリのスケーリングの限界を押し広げたいとも考えていました。中央値のアプリが小規模で低トラフィックな、数千万ものアプリをホスティングすることには、すでに長けていました。しかし、1つのアプリで数千万人の訪問者を支えるのはまったく別の問題であり、特有の課題があります。自分たちのために行う改善はすべて、Lovableでアプリを運用するすべてのビルダーに自動的に還元されます。
そして最後に、優れたウェブアプリを作るための社内の知見をビルダーエージェントにフィードバックし、すべてのユーザーが自分のアプリでその恩恵を受けられるようにしたいと考えました。技術スタックを統一したことで、これがかつてないほど簡単になりました。
背景:Lovableのアプリホスティングの仕組み
現在、LovableがビルドしてホスティングしているのはおもにTanStack Startのアプリです。このフレームワークは、アイソモーフィックな実行、デプロイのシンプルさ、型安全性という私たちのニーズに特によく合っています。採用の理由や使い方の詳細については、記事「TanStack Startでアプリを構築する」をご覧ください。公開された各Lovableアプリは、Cloudflareのworkerdランタイム向けの個別のワーカーとしてビルドされます。そして単一のエントリーワーカーが、コードを読み込み、ワーカーを動的に作成してリクエストをディスパッチすることで、すべてのアプリを配信します。
各動的ワーカーは、それぞれ独立したV8アイソレートのサンドボックス内で動作します。アイソレートとは、制御プロセスの中に存在するプライベートなV8ヒープのことで、別プロセスを使うよりも低コストな代替手段です。コンテナと仮想マシンの関係をイメージしてください。アイソレートのインスタンス化コストはワーカーバンドルのサイズに比例し、軽いもので4ms、巨大なバンドルでは最大1秒かかることもあります。アイソレートはキャッシュされて再利用されるため、読み込みとインスタンス化のオーバーヘッドは多数のリクエストで償却されます。これこそが、数百万のアプリを経済的に運用できる理由です。アイソレートは通常、LRU方式で、またはメモリ上限を超えたときにエビクション(破棄)されます。エビクションは必ずしもスムーズに行われるわけではありません。これについては後ほど説明します。
私たちはlovable.devを同じ方法で配信するために、TanStack Startへ移行しました。今では、6,000万以上あるユーザーのアプリと並ぶ配信先のひとつにすぎません。lovable.devの配信経路に固有のコードは200行未満です(主に、異なるリリースメタデータ形式と異なるオブザーバビリティ設定への対応)。
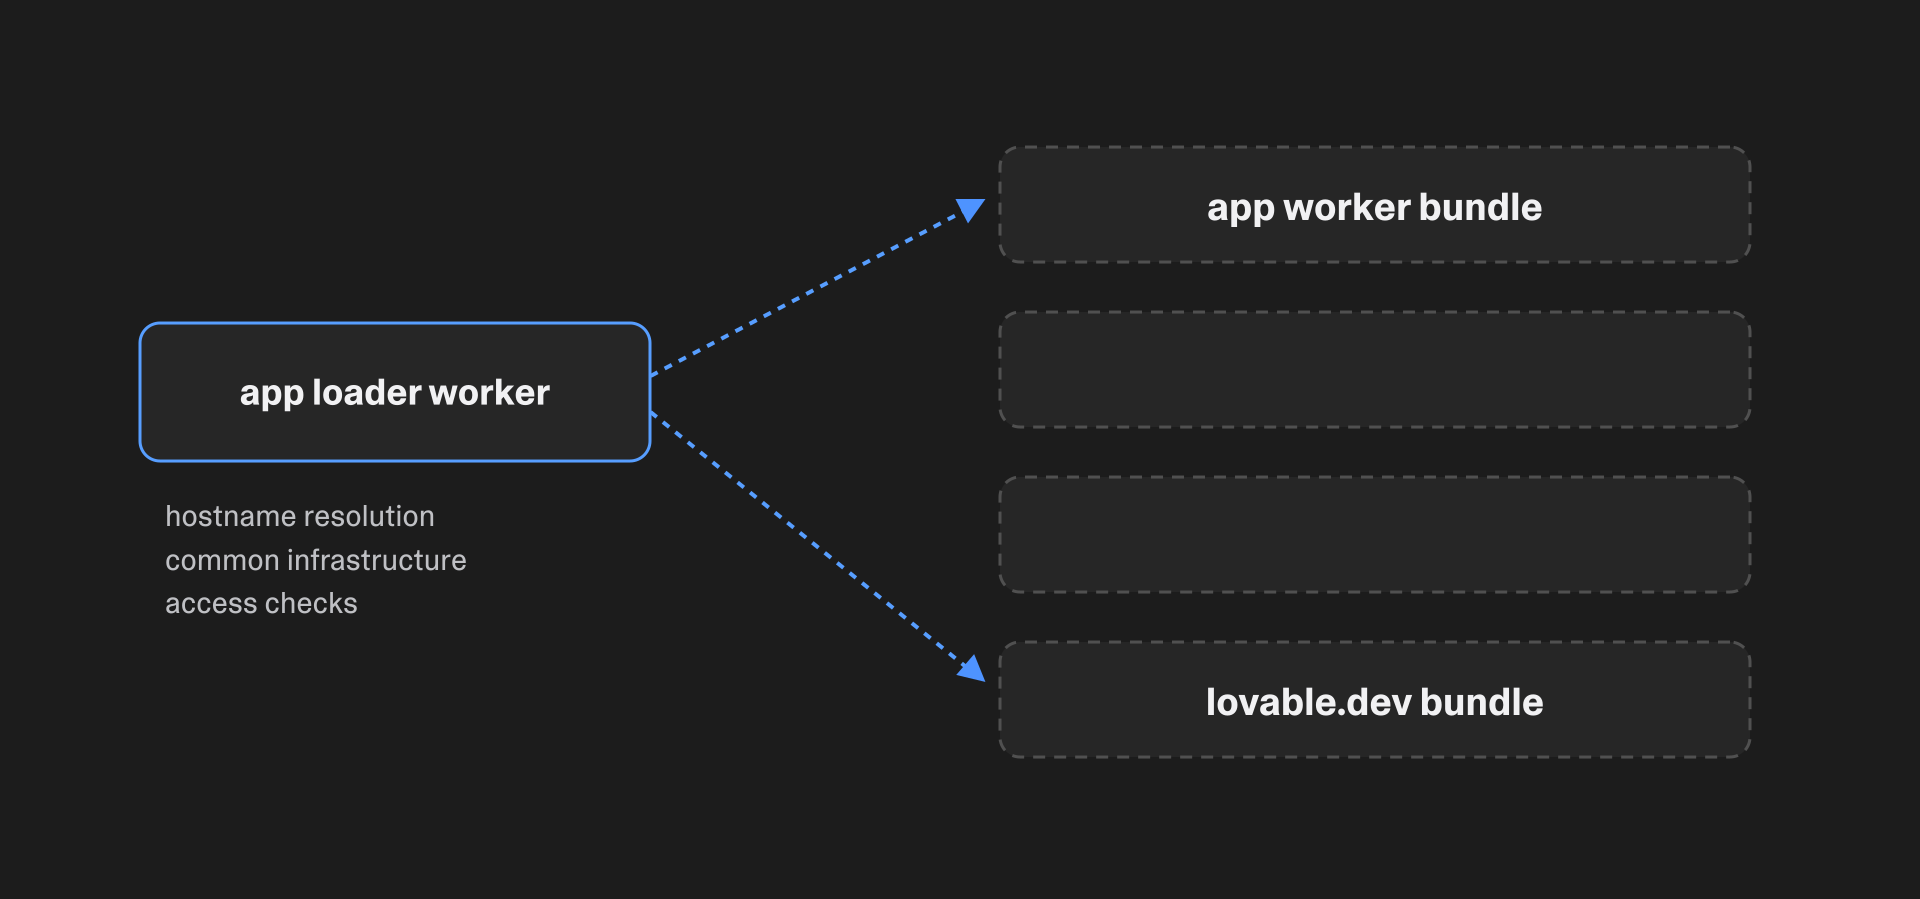
lovable.devは、ほかのすべてのLovableアプリと同じアプリローダーワーカーによって配信されています。6,000万以上あるバンドルのひとつにすぎません。
移行戦略
急速に開発が進むアプリの移行は、ゴールが逃げていく競争のようなものです。私はたった1人の開発者として、35万行のコードを前にこの移行を始めました。6か月後に移行が完了した時点で、アプリは85万行以上に膨れ上がっていました(その後さらに6万行が追加されています)。ここの人たちは、新しいものをリリースする手をまったく止めないのです。
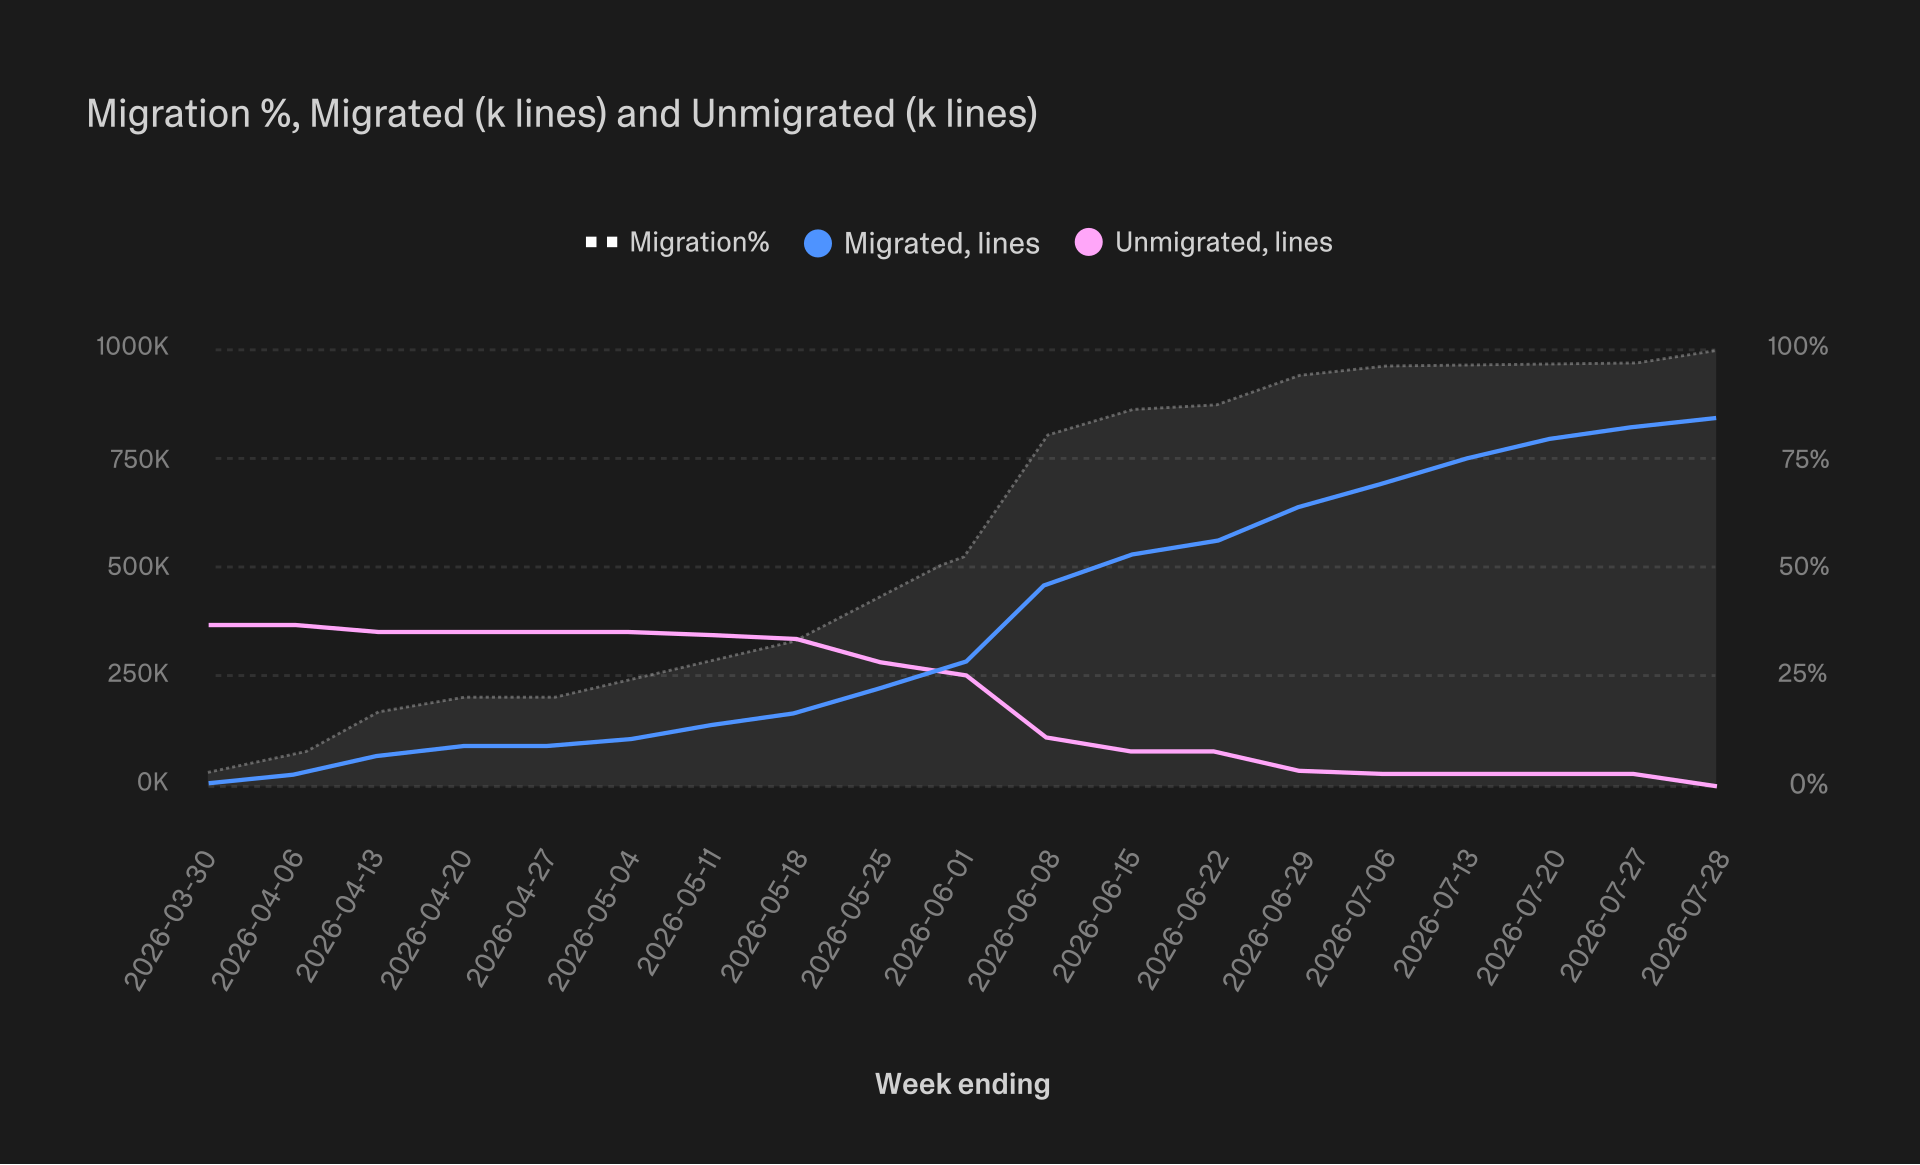
週ごとの移行の進捗。その間ずっと、全体の規模は増え続けました。
全体の計画は、Lovable入社前の仕事で大きく後悔した経験をもとに立てました。その経験とは、稼働中の旧システムと並行してビッグバン型の移行を進め、機能が同等になった時点で切り替えるというものです。今回は別のアプローチを選びました。両方のフレームワークですべてを動作させたまま、段階的に書き換えていく方法です。振り返ってみると、これが今回の移行で下した最も重要な決断でした。
2つのフレームワークを並行稼働させる
両方のフレームワークを並行して稼働させ、リクエストを適切な方へ振り分ける必要がありました。こうすることで、一度にすべてではなく、ルートごとに移行を進められます。
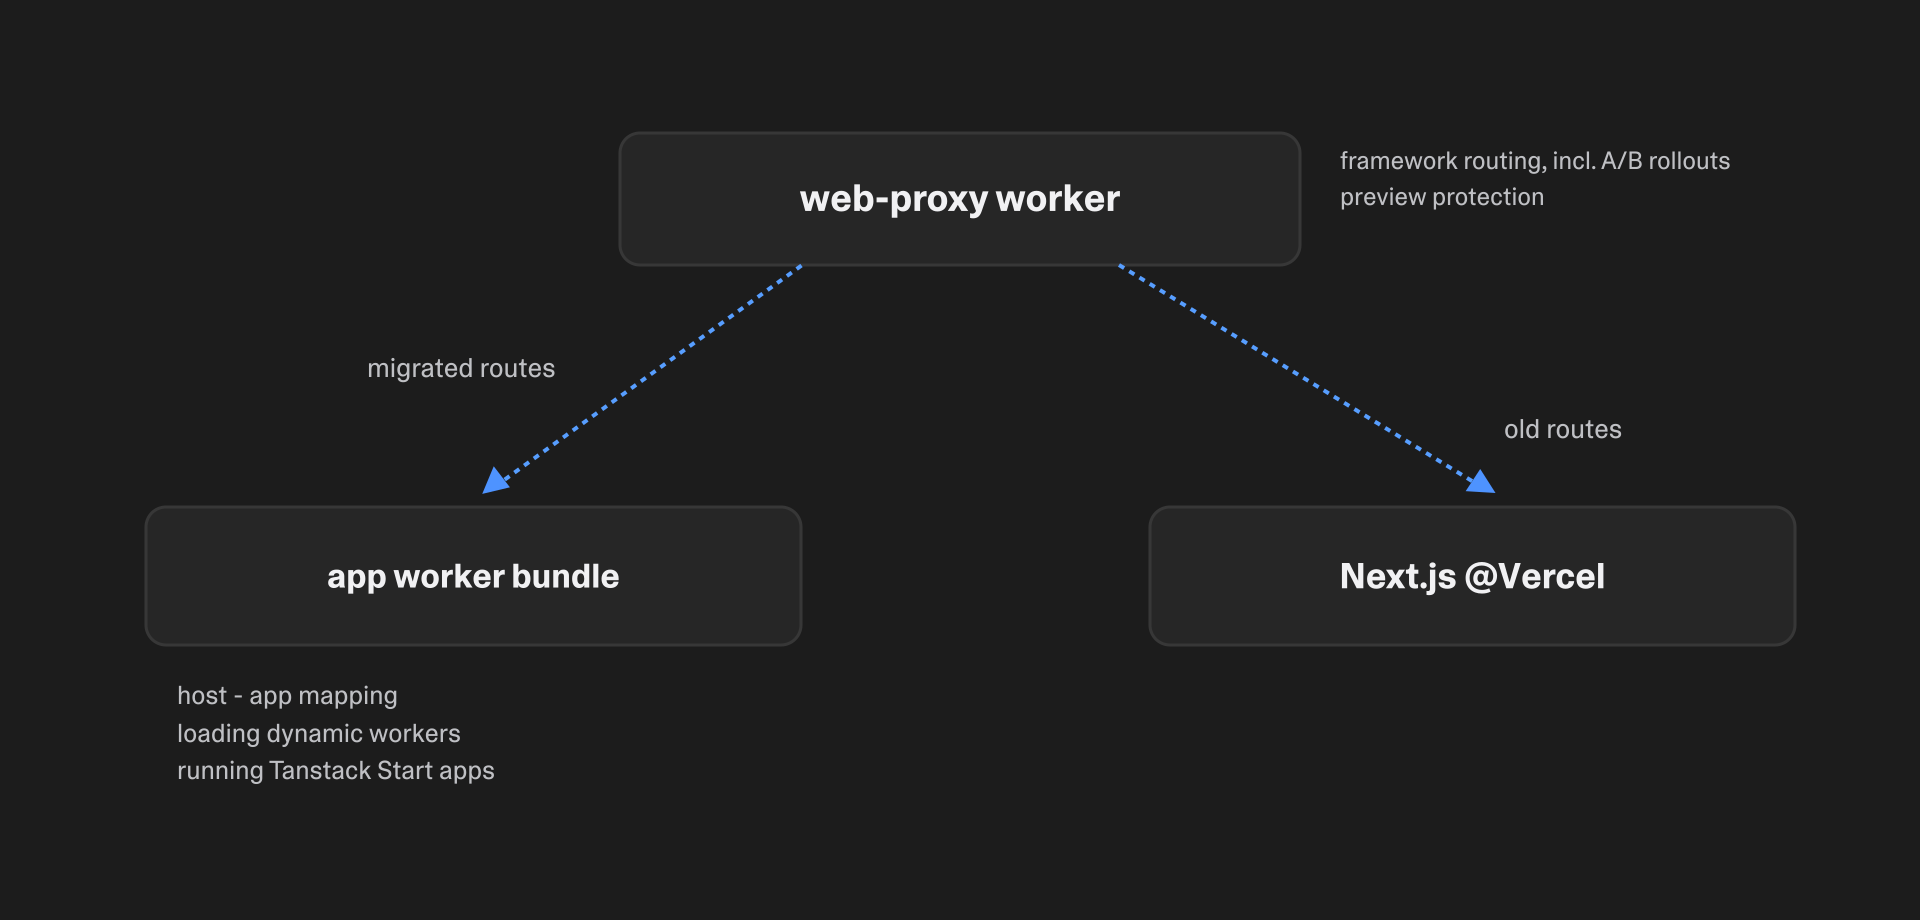
両フレームワークの前段に置いたプロキシワーカーが、ルートごと・ユーザーごとに、どちらがリクエストを処理するかを決定します。
この構成で重要なのがユーザー体験です。フレームワークの境界をまたぐとハードナビゲーションになり、ユーザーのブラウザは新しいドキュメントと新しいリソース一式を読み込む必要があります。これに対して内部(ソフト)ナビゲーションでは、新しいルートに必要な一部のスクリプトとデータだけを読み込み、それ以外はすべて再利用します。実際、ハードナビゲーションははるかに遅いため(移行前の実ユーザーの中央値で約5秒対約1.5秒)、その発生をできるだけ少なく抑える必要がありました。
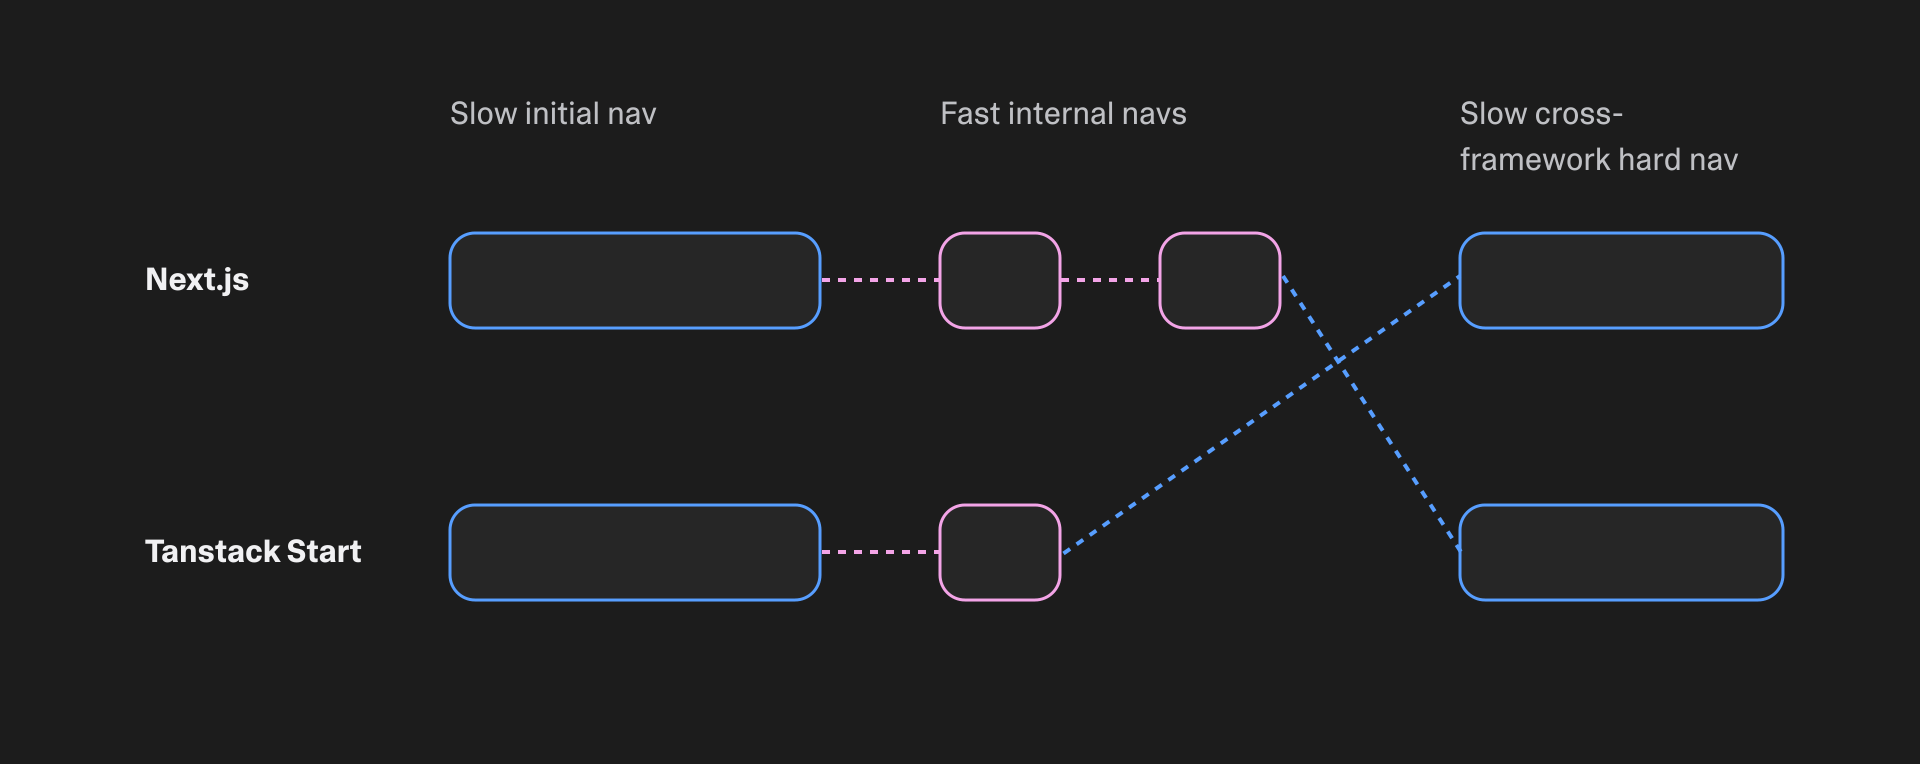
フレームワーク内のナビゲーションは低コストです。フレームワーク間をまたぐと、ドキュメント全体の読み込みというコストがかかります。
そのために、すべてのルートを典型的なユーザージャーニーに対応づけ、移行グループを作成しました。ユーザーが頻繁に行き来するルートは、まとめて移行するようにしたのです。最終的に、大きなグループが5つと、小さなグループがいくつかできました。グループ内の切り替えを段階的に行うため、各グループのロールアウトはフィーチャーフラグで制御しました。ロールアウト中は、設定可能な一定の割合(%)の訪問者が、どちらかのフレームワークにランダムに割り当てられます。
ハードナビゲーションをなめらかにする
ハードナビゲーションの見た目を改善する便利なテクニックが、ブラウザのドキュメント間View Transitions APIです。CSSのアットルールを1つ加えるだけで、デフォルトの白いフラッシュの代わりに、なめらかなクロスフェードのトランジションが適用されます。
@view-transition { navigation: auto; }
このトランジションは、遷移元と遷移先の両方のページにこのルールがある場合にのみ発動します。これを追加して以降、同僚たちは時間が長いこと以外でハードナビゲーションに気づかなくなりました。
フレームワークの固定(スティッキネス)
途中で解決した興味深い問題のひとつが、各ユーザーを最初にアクセスしたアプリに留めておくことでした。ユーザーAがプロジェクト設定のNext.js版を表示した場合、設定グループ内のすべてのルートでNext.jsに留まるべきです。TanStack Start版にアクセスしたユーザーBも同様に、グループ内では同じフレームワークに留まるべきです。これを解決するため、ルートレジストリをフィーチャーフラグのメタデータとともに切り出し、プロキシと両フレームワークにとっての信頼できる唯一の情報源としました。各フレームワークは、ラップしたルーターコンポーネントを通じて、どのルートでソフトナビゲーションとハードナビゲーションを使うべきかを把握できるようになりました。
決定的なフィーチャーフラグ
フィーチャーフラグがランダム化されている場合、どうやってエンドツーエンドのテストを行えばよいのでしょうか。私はフレームワークの選択を決定的に上書きできる仕組みを作り、テストで両方のフレームワークを確実にカバーし、どちらも期待どおりに動作することを検証できるようにしました。プロキシサーバーは内部用の検索パラメーターを認識し、ランダムな値の代わりに、そこで指定されたフィーチャーフラグを割り当てます。これはフィーチャーフラグを持つあらゆるシステムで広く役立つ機能です。テストは決定的であるべきで、その時点で進行中のランダムなロールアウトの影響を受けるべきではないからです。
コードの共有
次の目標は、Next.jsとTanStack Startの間でコードを共有する仕組みを作ることでした。目指したのは、フレームワーク固有のコードを5〜10%、フレームワークに依存せず両方で共有するコードを90〜95%にすることです。最終的にこれを達成し、削除される直前のNext.js固有のコードは、ウェブのコードベースの3%でした。
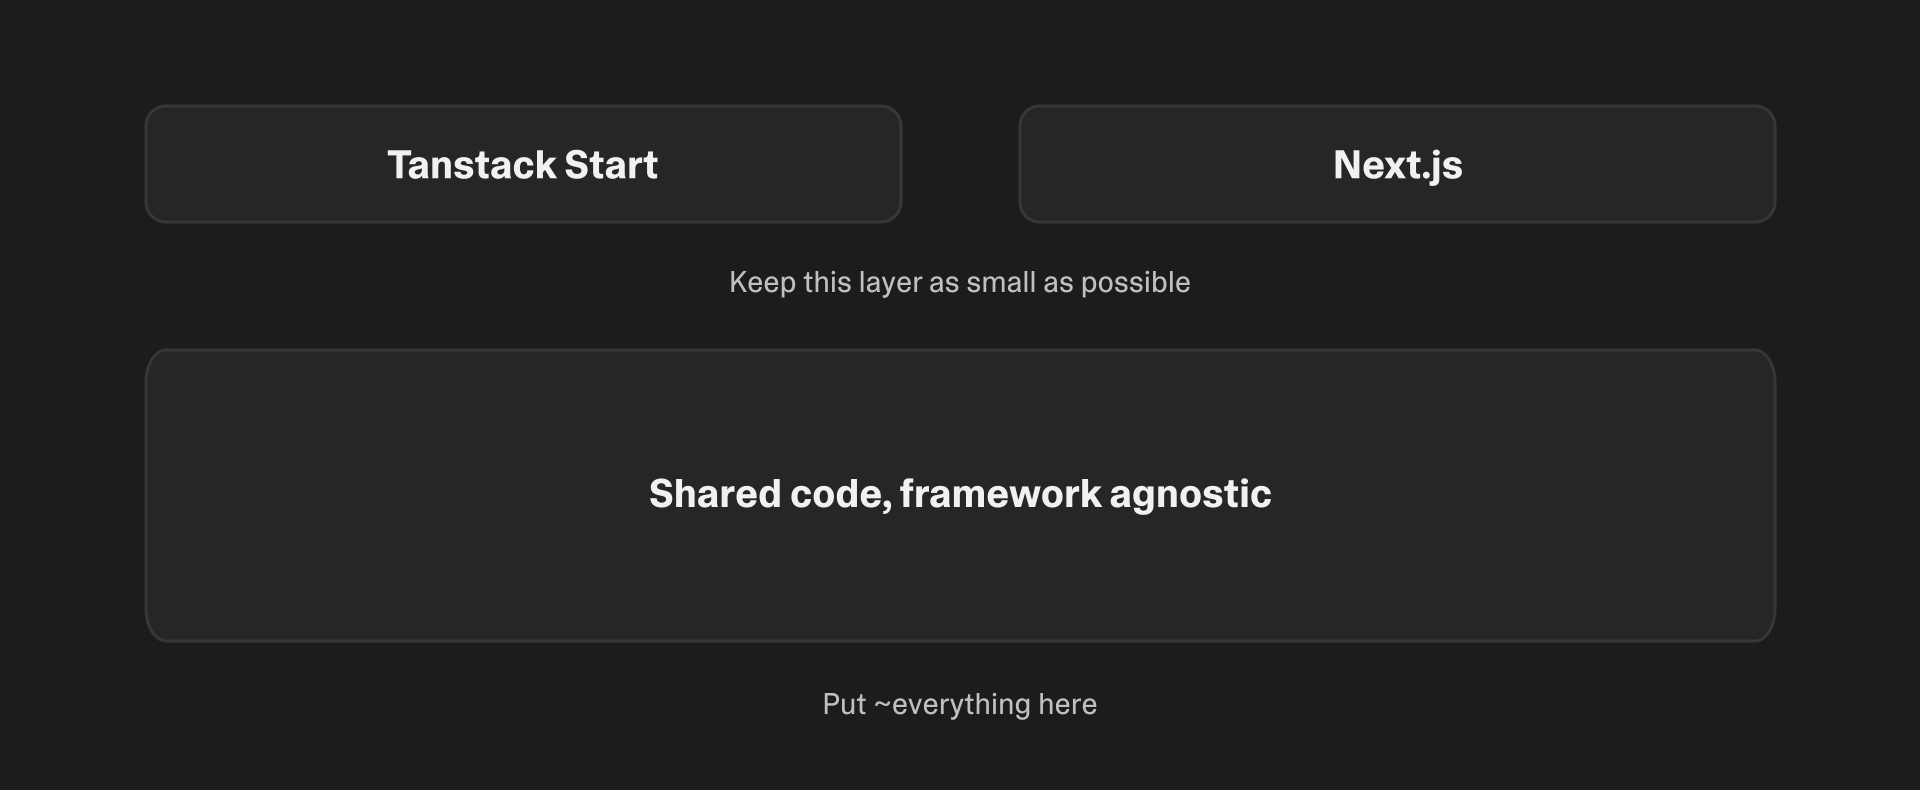
目指した形:フレームワークに依存しない大きなコアの上に、薄いフレームワーク層を重ねる構成。
共有コード専用のルートフォルダーを用意し、#shared/エイリアスを両フレームワークのモジュール解決に組み込みました(package.jsonのimportsで設定し、型チェッカー向けにtsconfig.jsonのpathsにも同じ内容を反映)。さらに、共有コードがどちらのフレームワークもインポートしないことを検証するlintルールを追加しました。
// web/package.json (TanStack Start)
"imports": { "#shared/*": "./shared/*" }

// app/package.json (Next.js)
"imports": { "#shared/*": "../web/shared/*" }
// works identically in either framework
import { buildUrlPath } from "#shared/lib/routes";
// oxlint.config.ts—shared code stays framework-agnostic, enforced
{
  files: ["web/shared/**/*.{ts,tsx}"],
  rules: {
    "no-restricted-imports": ["error", {
      paths: [
        { name: "next", message: "Shared code cannot depend on Next.js." },
        { name: "@tanstack/react-start", message: "Shared code cannot depend on TanStack Start." },
        { name: "@tanstack/react-router", message: "Shared code cannot depend on TanStack Router." },
      ],
      patterns: [
        { group: ["next/*"], message: "Shared code cannot depend on Next.js." },
        { group: ["node:*"], message: "Shared code cannot use Node.js APIs. Must be runtime-agnostic." },
      ],
    }],
  },
}
この構成全体をAGENTS.mdに記述し、何度か改善を重ねた結果、新機能はデフォルトでポータブルな形で書かれるようになりました。
リグレッションを防ぐ
移行の途中で、もう1つのチェックを追加しました。「#sharedの外に新しい機能コードを書かない」というものです。「機能コード」はあいまいな概念ですが、決定的なチェックではなくエージェントによる自動化を使うことで、検証可能になりました。これにより、ポータブルでない新しいコードの混入を防げただけでなく、何らかの理由で進行中の移行を知らなかった開発者への周知にもつながりました。以下は、このチェックがPRが準拠していると判定した例です:
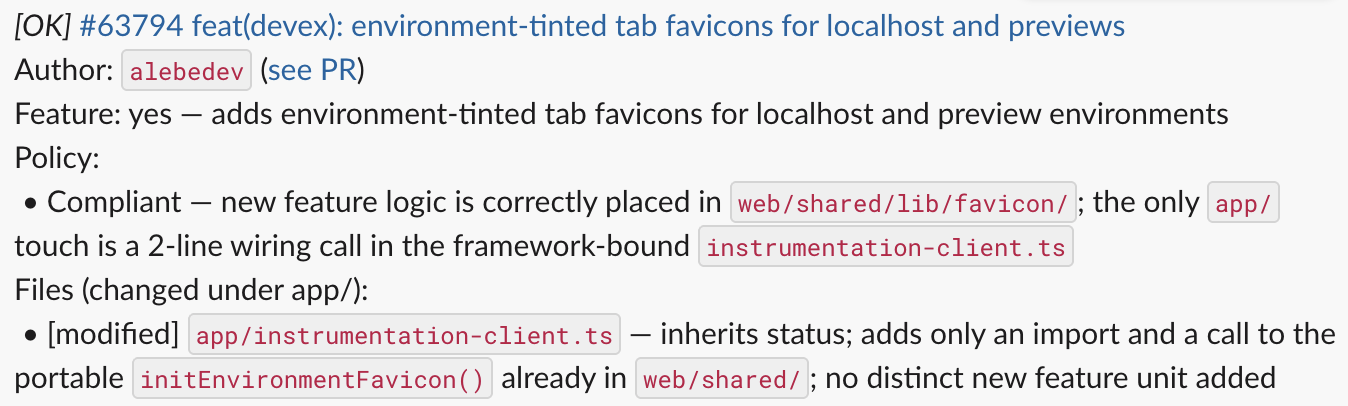
ポータビリティチェックはファイルごとに判定の理由を説明するため、作成者はまさに必要なタイミングでルールを学べます。
アダプターと互換レイヤー
コードを共有できるようになったとして、深くネストされたコンポーネントがナビゲーションボタンを表示するためにnext/linkをインポートする必要がある場合は、どうすればよいでしょうか。そうしたコンポーネントをいちいちフレームワーク固有の部分に置いておくのは避けたいところです。トップレベルのプロバイダーを介した依存性注入も一時は検討しましたが、それにはインポートをコンテキストからの読み取りに置き換える必要があります。大きな変更であるうえ、注意しないと実行時のオーバーヘッドが生じるおそれもあります。
最終的に実装したのは、一種のインターフェースベースの依存性注入です。共有コードが共通項となるインターフェースを宣言し、各フレームワークがそれを実装します。そしてTypeScriptのインポートエイリアスのおかげで、依存性注入の仕組みを明示的に扱うことなく、必要なものをインポートするだけで済みます。
// app/tsconfig.json:  "@platform/router": ["./lib/router/next-adapter.ts"]
// web/tsconfig.json:  "@platform/router": ["./lib/router/tanstack-adapter.ts"]

// next-adapter.ts
export { usePathname } from "next/navigation";

// tanstack-adapter.ts
export function usePathname(): string {
  return useLocation({ select: (loc) => loc.pathname });
}

// shared code, works under either framework
import { usePathname } from "@platform/router";
プラットフォームアダプターは、コードの90%以上を共有部分に移すための最後のピースでした。
コアまで削ぎ落とす
フレームワーク依存の部分を小さく保つ方法のひとつは、そもそもフレームワークのAPIをあまり使わないことです。いずれにせよ最終的には別のものに置き換える必要があるのですから、早めに着手して、フレームワーク固有のAPIの一部をフレームワークに依存しないものに置き換えてはどうでしょうか。私たちの場合、それはnext/fontとnext/image、そして認証とi18nのソリューションでした。後者の2つは、いずれもNext.jsに依存するサードパーティライブラリの上に構築されていました。
Next.jsを稼働させたままこうした先行移行を行ったことで、全体のリスクが下がり、すぐに成果も得られました。たとえば、新しい自社製の認証ライブラリによって安定性が向上し、Firebase Authの呼び出し回数が10分の1以下に減りました。また、新しいi18nソリューションによって、実行時のパフォーマンス(ページ読み込み時のi18n初期化のCPUコストが約3分の1に)とコンパイル時の安全性(翻訳キーのスペルミスが型チェックエラーになる)の両方が向上しました。
フレームワークへの依存範囲が小さくなったところで、いよいよ移行そのものを始められるようになりました。
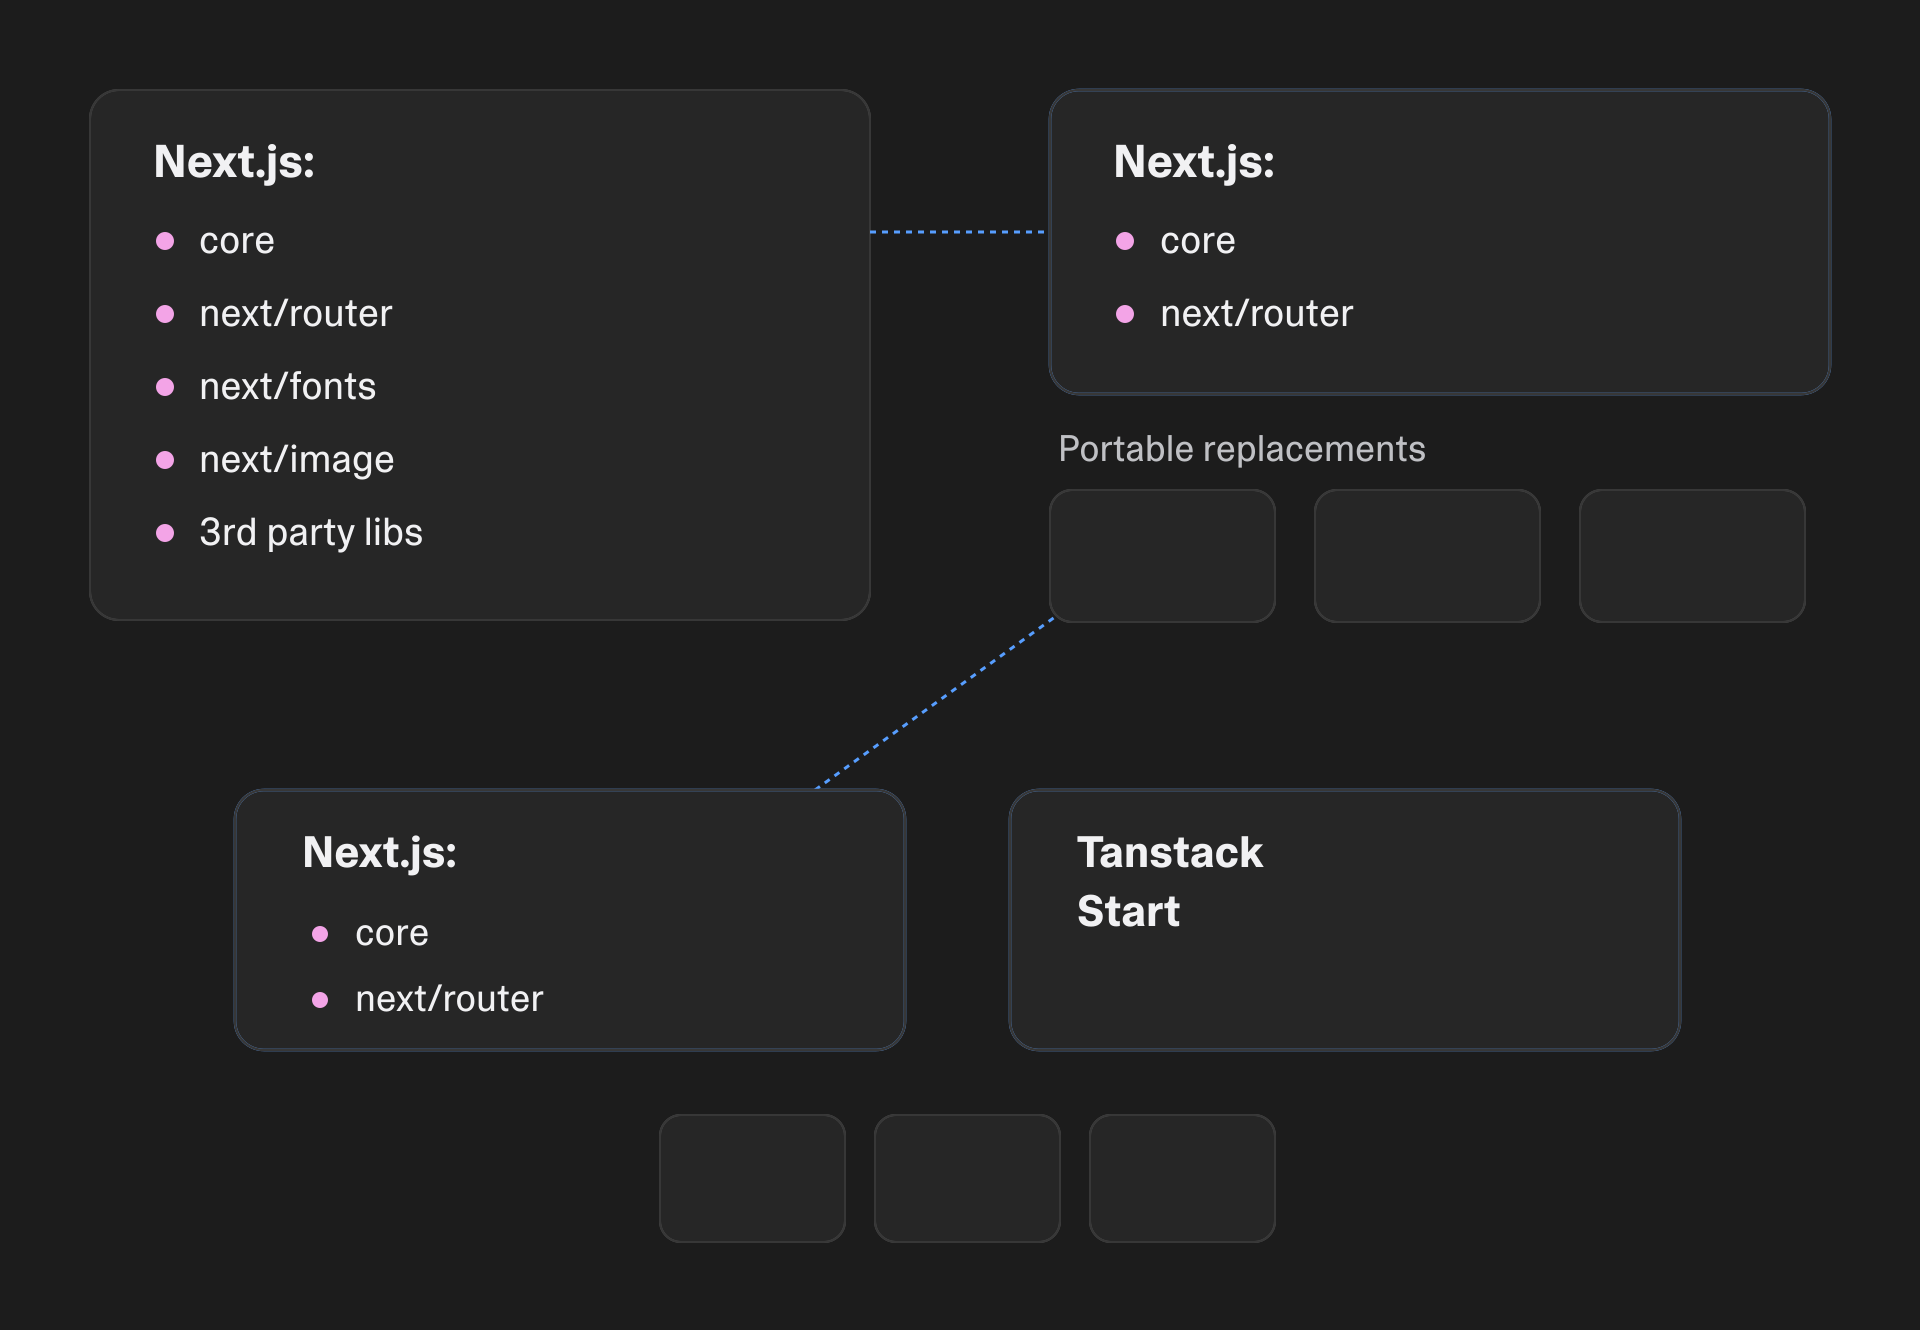
先にフレームワークのAPIをポータブルな代替手段に置き換えたことで、移行で対処すべき範囲が縮小しました。
AIを活用したコード移行
移行を計画した当初の戦略は、「まずツールをすべて作り、その後、作業の大部分をプロダクト機能を所有・保守している各チームに分配する」というものでした。しかしこの戦略は、現実に直面して形を変えました。良い意味で、です。まず「エージェントがPRの草案を作り、オーナーがレビューとテストを行う」という形になりました。さらに草案の品質が十分に高いことがわかり、私自身がバッチごとにレビューしてマージするようになりました。結局、移行作業の担当分を受け取ったチームはひとつもありませんでした。
移行作業が進むにつれて、いくつかの手法が自然と生まれました。
1つ目は、「コンポーネントXを共有Webコードに移行して」と依頼するだけで、本番環境に投入できるPRが返ってくるようにするためのスキルとエージェントナレッジのセットです。ある種の作業を数十回、数百回と繰り返すことが予想される場合は、プロンプトの共通部分を再利用できる形で切り出しておくと大きな効果があります。コードをコピー&ペーストする代わりに、再利用可能なコードとして切り出すのと同じ考え方です。これにより、人への引き継ぎも大幅にシンプルになります。同僚に「このコンポーネントの移行をエージェントに頼んでみて。やり方はもう知っているから」と伝えて実際にうまくいった最初の数回は、まるで魔法のように感じました。人に伝える必要があるのは大まかな概要だけで、細部は各自のエージェントが必要に応じて補ってくれるなら、大規模なチームでの取り組みを調整する時間を大幅に節約できます。数か月のうちに、増え続ける開発チームがそれぞれの作業に取り組んでいる間に基盤となるWebフレームワークを置き換えましたが、ほとんど誰も気づきませんでした。これは本当に素晴らしい体験でした!
2つ目の有用な改善は、エージェントによる計画の抽象度を引き上げたことです。最初ははしごの一番下から始めました。低レベルの目標を私が設定・追跡し、計画と実装をエージェントが行う形です。たとえば、プロジェクト一覧をTanStack Startで完全に表示できるようにする際には、共有コードへの移行が必要なReactのコンテキストプロバイダーを21個特定しました。各プロバイダーは、それぞれ個別のLinearチケットで追跡しました。それらのプロバイダーを移行している途中で、それぞれに必要な興味深い判断が実はごくわずかしかないことに気づきました。そして退屈な作業はすべて、十分に良い委任方法が見つかり次第、AIに任せるべきです。最終的にその委任は、/goalループを1段上のレベル、つまり実装ではなく計画に適用したような形になりました:
- 測定可能な移行指標(例:「Next.jsのUIがまだ残っているエージェントツールはいくつあるか」)を定義し、それを決定論的に測定するスクリプトを書きます。
- その結果をプランナーエージェントに渡し、十分な大きさの移行作業のバッチを特定させます。「上記の移行のうち、PRスタックとして実装できるまとまりのあるサブセットを特定してください。PRは最大12件、1PRあたり800..1600行が望ましいサイズです」。こうして特定したバッチは、その後、実装エージェントに引き渡されます。全体のプロセスについては、エージェントによるコーディングのスケーリングに関する記事で詳しく書いています。
- 指標がゼロになるか、大きな障害にぶつかるまで続けます。完全な移行に近づくための次の指標を特定し、これを繰り返します。
3つ目の有用な発見は、移行に特化したレビューの自動化です。新しいコードに含まれる移植性のないパターンを特定し、代わりにどうリファクタリングすべきかを作成者に伝える仕組みです。マージされたすべてのPRをエージェントが分析し、互換性の要件を満たしているかを確認しました。摩擦を減らすため、既存機能への小さな修正は対象外としました。互換性のない新機能や大きな変更があれば、作成者にアラートが送られます。修正方法はいつもどおり、「エージェントに互換性を持たせるよう頼んで。やり方はもう知っているから」です。こうして全員が、Webコードの互換性を保つ方法を必要な分だけ、適切なタイミングで学べました。この自動化のおかげで、移行の終盤に「しまった、これはまだ移植されていなかった」という想定外の事態は異例なほど少なく済みました。
結局のところ、エージェントはコードの移行と正しさの検証を十分にうまくこなしてくれました。エージェント主導の探索的チェック、私自身が実施したスモークテスト、そして段階的なロールアウトによって十分な確信が得られたため、コードオーナーを巻き込む必要は一度もありませんでした。2年前なら複数チームの連携が必要だった作業を、1人の開発者とエージェントの一団でやり遂げたのです。移行の成果は通常、数回の小さな修正を経てスモークテストに合格しました。そして、TanStack Start版のlovable.devを実際のユーザーに提供し始められるだけの状態になりました。
トラフィックの切り替え
トラフィックは、ルートグループごとに1つずつ切り替えました。各ルートグループについて、多段階のA/Bロールアウトを実施しました。限定的な社内テスト → 全社での社内テスト → ユーザーの1%、そして段階的に100%まで、という流れです。私たちのような大規模に統合されたシステムでは、すべての挙動を分析的に予測することは事実上不可能です。そのため、主な品質管理の手段は、優れたフィードバックループ、迅速にロールバックできること、そして素早く修正できることになります。最初のいくつかのルートグループでは、移行後の問題をすべて見つけて修正するまで、社内テストに最大1週間かかりました。外部ユーザー向けの期間も同程度でした。問題は少なかったものの、先に進む前に小さな割合のロールアウトから適切なシグナルを確実に得られるよう、時間をかけたためです。
複数のロールアウトを並行して進めると混乱しやすいため、1%から100%へと引き上げていく外部ロールアウトは常に1つだけになるようにしました。社内テストの結果から開始の準備が整っていると判断できても、次のロールアウトはキューで待機させました。システムのさらに別の部分を移行する作業が常に並行して進んでいたので、ロールアウトを急ぐ必要はありませんでした。最後のいくつかのグループは最初から最後まで約1週間で、良い意味で退屈なものでした。
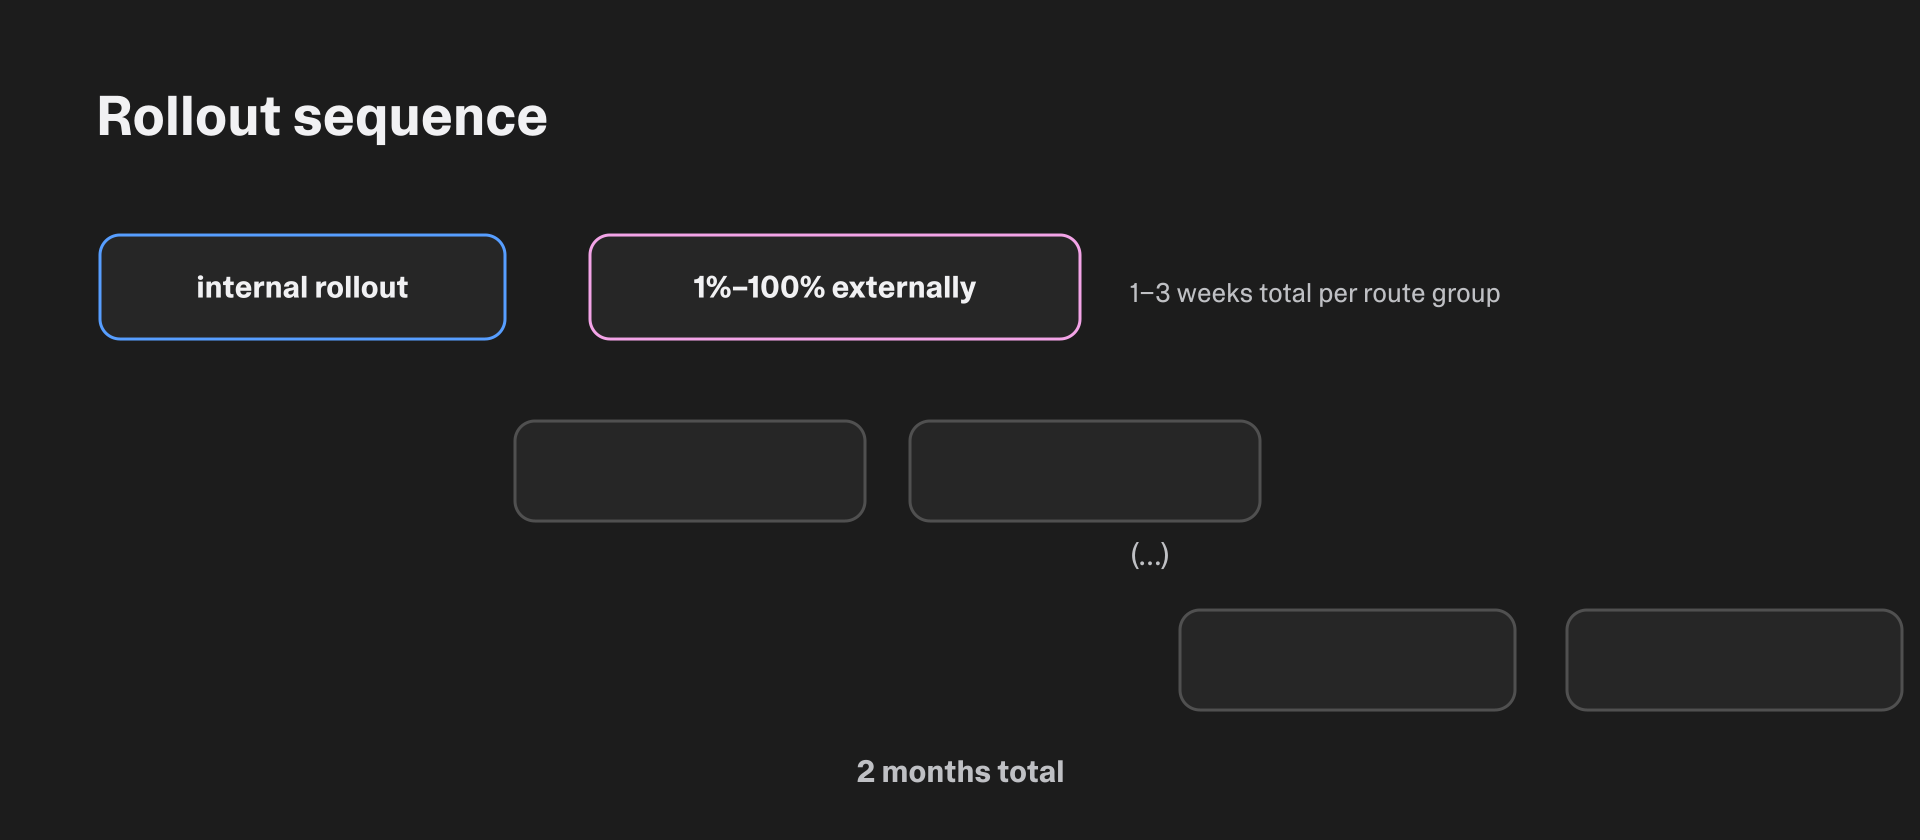
外部ロールアウトは常に1つずつ、ルートグループごとに時期をずらして実施。全体で2か月。
ロールアウトのログを監視していると、最もわかりやすい障害はクラッシュと機能上のバグです。それほど目立たないものの、少なくとも同じくらい重要なのがシステムのパフォーマンスです。私たちはサーバーの応答時間、サーバーのエラー率、Web Vitalsを監視し、それぞれについてフレームワーク同士を比較しました。パフォーマンスの問題の大半は、多くのユーザーに影響が出る前に特定して修正できました。ただし、すべてではありません。もう一度やるなら、パフォーマンスの監視にさらに時間をかけ、指標上で遅く見える変更はもっと積極的にロールバックするでしょう。
パフォーマンス最適化についての教訓をひとつ。合成指標と実ユーザーの指標の両方を見るべきです。合成指標はノイズが少なく、エージェントのループに組み込みやすいため、最適化を進めやすくなります。一方、実ユーザーの指標こそが最終的な目標です。変化は遅く、直接的に動かすのは難しいものの、ユーザーにとってのシステムの実際の状態を反映しています。
全体として、ロールアウトには約2か月かかり、その大部分はコードの移行と並行して行われました(移行作業がなくなり、ロールアウトだけに専念したのは最後の2〜3週間のみです)。ここには明らかにリスクと時間のトレードオフがありますが、私たちが取った比較的慎重なロールアウトのアプローチにはかなり満足しています。おおむね、ですが。ある1件では、盛大に失敗しました。
メモリ不足インシデント
最大のルートグループのロールアウトを終えたばかりでした。スムーズに進んだこともあり、私は本来あるべき以上に楽観的になっていました。次のルートグループはダッシュボードでした。コード量もリスクも少ないものの、ログインしているすべてのユーザーが通る導線上にあります。社内ロールアウトは何事もなく終わり、公開ロールアウトで割合を少しずつ引き上げ始めました。1%。5%。金曜日の昼前に20%に設定しました。すると午後になって、パフォーマンスに関する苦情が届き始めました。さらにエラー率が上昇しました。最初はじわじわと、そして突然に。まず0.1%から0.5%に上がりました。その後わずか数分で約50%に達し、設定していたすべてのアラートが鳴り響きました。
インシデントは11分間続きました。よくあることですが、すべてを壊したコミットをロールバックするほうが、そもそもなぜそれが起きたのかを理解するよりもはるかに速く、簡単でした。結局のところ、私たちは限界ぎりぎりのところで運用していたのです。私たちの場合、その限界とはランタイム環境のメモリ上限でした。公開Webサイト用の静的データJSON(まったく関係のない機能で、オフになっているフラグの裏に隠されていたもの)を移行したことで、上限を超えてしまいました。追加された数MBが、最後の一押しになったのです。ダッシュボードのロールアウト拡大は根本原因ではなく、最悪のタイミングでより多くの人をこの問題にさらしただけでした。
なぜ壊れたのでしょうか。V8 isolateは本来、何度も何度も再利用されることを前提としています。ところが私たちのisolateは、メモリ上限を超えて強制終了されるまでに、平均して10件未満のリクエストしか処理していませんでした。比較として、現在のベースラインはisolateあたり500〜10Kリクエストで、主にデプロイ頻度によって変わります。そしてisolateが強制終了されると、その時点で処理中のリクエストはすべてエラーになります。
ここで私は何を間違えたのでしょうか。初期のメモリ使用量を測定していませんでした。早期の警告を無視し、0.1%のエラー率を、移行が終わってから対処すればよいものとして受け入れてしまいました。つまり、楽観しすぎて、実際のデータを十分に見ていなかったのです。
何が悪かったのかが正確にわかると、長期的な対策は、この問題にさらにAIを投入することだと思えました。「サーバーリクエストにおけるメモリ使用量の測定方法はこうです。削減するためのアイデアを10個出してください。プロトタイプを作って測定してください。良いものはそれぞれPRとして適用してください」。必要なのは、時間とトークン、そしてどのアイデアが有望かを見極めるエンジニアリングのセンスだけです。最近では、典型的な1日のメモリ不足エラーはゼロになっています。
そこで効果があったメモリ改善の例をいくつか紹介します:
- 静的コンテンツを含む数メガバイトのJSONをモジュールレベルでパースしないこと。そうしたオブジェクトはサーバーのメモリに永久に残り続けます。生の文字列としてインポートし、リクエストハンドラー内でパースするようにしたことで、ルートによってはメモリ消費量が2分の1から12分の1に削減されました。
- リストAPIから未使用のフィールドを除外したことで、テンプレートで数MBを節約できました。テンプレートは数百個あり、カタログページでは完全な説明文は一切必要なかったためです。
- サーバーバンドル内のクライアント専用コードを空のスタブに置き換えること。lovable.devの一部は実質的にブラウザ上のIDEであり、そのコードの大半はサーバー側では不要でした。TypeScriptコンパイラ、Prettier、シンタックスハイライターなどのコンポーネントを除外したことで、サーバーバンドルのサイズを約9MB削減でき、ワーカーのメモリに換算すると18MBの削減になりました。バンドルのバイト数は、メモリ上ではおよそ2倍になります。V8は、文字列にLatin-1以外の文字が1文字でも含まれていると、文字列全体に2バイト形式を使うからです。バンドル全体は1つの文字列として読み込まれ、私たちのロケールデータにより、その文字列には必ず国際文字が含まれます。上限が合計128MBともなると、こうしたことが効いてくるのです。
TanStack StartとNext.jsの比較
長年Next.jsを使い、その後、自分史上最大のプロジェクトをNext.jsから移行した経験を踏まえた、個人的な振り返りをいくつか紹介します。
ローカル開発体験の向上
TanStack StartはViteの開発サーバーを使用しており、Next.jsと比べて起動が速く、RAM消費量も数分の1です。私たちのコードベースでは、TanStackが起動10秒/RAM 1.5GB、Next.jsが起動70秒/RAM 8GBという差があります(数値は私のMacBook M4 Maxで計測したもので、計測中に他の大きな負荷はありませんでした)。さらに、Next.jsで20GB以上のRAMを消費していると嘆く同僚もいました。バックエンドサービスをデバッグしようとしていて、ローカルのフロントエンドはそれほど必要ないときに、決して見たい光景ではありません。
最新のハードウェアであってもRAMは常に足りないので、メモリ使用量が少ないのは本当にありがたいことです。また、1時間に何度もブランチを切り替える場合、起動時間はさらに重要になります。
これはTurbopackを有効にしたNext.js v16.2での結果です。新しいv16.3では、開発サーバーのメモリ使用量を最大90%削減するとされています。
Next.jsの抽象化には今でも戸惑う
Next.jsは、サーバー/クライアントのアイソモーフィズムに関する複雑な側面すべてに取り組んだ、最初の人気フレームワークでした。現在の形にたどり着くまでに何度かの試行錯誤が必要だったのも無理はありません。私自身も含め、多くの開発者がサーバーコンポーネント、サーバーアクション、レイアウトとページの分離に戸惑っているのを見てきました。単に私のスキル不足かもしれませんが、本当にわずらわしいのです。
TanStack Startはこの点で業界に蓄積された経験を土台にしており、導入している抽象化が少ないため、私には理解しやすく感じられます。TanStackのサーバー関数、ルートローダー、ネストされたルートについては同様の混乱は見られず、より直感的に感じられます。
TanStack Startのほうがエージェントの性能が上がる
Next.jsの厄介な問題に対処する際、エージェントから時代遅れで的外れなアドバイスを受けたことを覚えています(App RouterでPages RouterのAPIを使おうとする、v14のキャッシュのデフォルトがv16でもそのまま当てはまると想定する、など)。原因の多くは、インターネット上の古い知識か、当時私たちが使っていた特定のNext.jsバージョンにとって正しい解決策が何かをエージェントが見失っていることでした。Next.jsのv12、v14、v16が互いに大きく異なるという事実は、エージェントにとって扱いやすいものではありません。多くの学習ソースでは、フレームワークのバージョンや、Pages RouterかApp Routerかなどが明記されていないからです。
TanStack Startは新しいため、この問題がないように感じます。私のエージェントは最初から正しく扱えることが多く、見かけるミスもフレームワークの誤解に起因するものではありません。私の見立てでは、エージェントにとっては、内部に矛盾を多く抱えた大規模な学習コーパスよりも、小さくても一貫性のあるコーパスのほうが優れています。エージェントはドキュメントや周辺のコードを読むことで知識の不足を補えますが、自信を持って身につけた誤った癖を捨て去るのは簡単ではありません。
大規模なTanStack Startアプリでは、バンドラーの設定が多く必要になる場合がある
Next.jsでは、最適なコードバンドリングはほぼ解決済みの問題のように感じます。本番ビルドは、たいてい何も設定しなくても効率的です。私が主に使っていた最適化の手段は、依存関係の削除と、next/dynamicによるバンドル分割ポイントの追加でした。
一方、TanStack Startでは、良い結果を得るためにかなり低レベルな設定が必要でした。エージェントはこの種の最適化をよく理解していますが、その必要性に気づき、エージェントに作業させるのはやはり人間の役目です。現在のlovable.devのビルド構成には、17個のカスタムビルドプラグイン(カスタムのコード分割、複数のカスタム開発環境のサポート、アセットパイプラインなど)があります。状況によって異なるとは思いますが、私たちのような規模のアプリケーションで設定がまったく不要だとは考えないほうがよいでしょう。
移行で得られたもの
今回の移行の最大の理由であり、最大の成果は、自社製品を自ら使うドッグフーディングです。ただ、それ以外にもいくつかの副次的な成果がありました。
パフォーマンス
ユーザーにとっては、ほとんどのWeb Vitalsが移行前と同等の水準です。全体的にはレスポンスが速くなり、TTFBの中央値は49%短縮しました。一方で、ロングテールは遅くなりました。当初はp90が最大で2倍遅くなり、改善には手間がかかりました(現在は移行前と比べて16%短縮しています)。クライアント側の指標はあまり変わっていませんが、以前より最適化しやすくなったと感じています。
私たち開発チームにとっては、ローカル開発とCI/CDの両方でビルド時間が短くなりました。以前はWebサイトの本番ビルドがCIチェックの中で最も遅いことが多く、12分以上かかることも珍しくありませんでした。現在は6〜9分で、しかもまだ一度も最適化に取り組んでいません。このセクションを書いている間にも、さらに2分短縮できる箇所を見つけたほどです。1日に何百回もデプロイする会社では、1分1分が重要です。
AIを活用したツール
これほど大量のコードを一人で扱う必要があったため、AIコーディングをどこまでの規模で活用できるか、その限界に挑むことになりました。移行のために作ったスキルやツールは、今も私や同僚が日々の業務で使っています。
セルフ編集
lovable.devとユーザーのアプリで同じスタックを使うことのもう一つの利点は、セルフ編集に対応しやすくなることです。現在では、Lovableを使ってlovable.devを編集し、変更をリアルタイムでプレビューできます。これは、Lovableの非エンジニアの社員がセルフサービスで編集する際の主な手段になっています。誰もがビルダーであり、誰もがLovable自体をより良くできるのです。開発者も日常的にセルフ編集を使っていますが、その話はまた別の記事で詳しく紹介する予定です。
今後の展望
Lovableには、TanStack StartのWebアプリケーションという明確な方針に基づいた技術スタックがあります。しかし、私たちのエージェントとインフラは、すでにはるかに幅広い技術に対応できます。開発については、サンドボックスVM上であらゆるものを実行できます。私たちはこの機能を活かして、誰でも既存のあらゆるソフトウェアをインポートして編集できるようにしたいと考えています。ですから、そう遠くないうちにNext.jsアプリをインポートできるようになっても驚かないでください。Next.jsから移行したばかりなのに皮肉な話ですが、最終的に私たちが目指しているのは、Lovableでどんなソフトウェアでも編集できるようにすることです。