データベースのドキュメントにフィールドを1つ追加することが、ユーザーのブラウザに何が見えるかを決めることにまでなってはいけません。
しかし、フロントエンドがFirestoreを直接リッスンしていた構成では、実際にそうなり得ました。ブラウザはドキュメント全体を受け取り、権限はFirestoreルールとGoバックエンドの間で常に同期させておく必要があり、他のデータベースのデータを必要とする機能はその境界に阻まれていました。私たちに必要だったのは、各ユーザーが何を受け取るかをバックエンドが決め、データと権限の両方が変化するのに合わせてその判断を常に最新に保つことでした。さらに、数百万件のライブサブスクリプションという規模で、それを効率的に行う必要もありました。
そこで私たちは、独自のリアルタイムサービスであるLovable Realtimeを構築することにしました。
コア部分は私自身が実働40日で構築しました。そして私たちは、ユーザーに影響するインシデントを1件も起こすことなく、全ユーザーへの展開を完了しました。このサービスはピーク時に200万件を超える同時サブスクリプションを処理し、月間約26億のデータフレームとパッチフレームを配信しています。
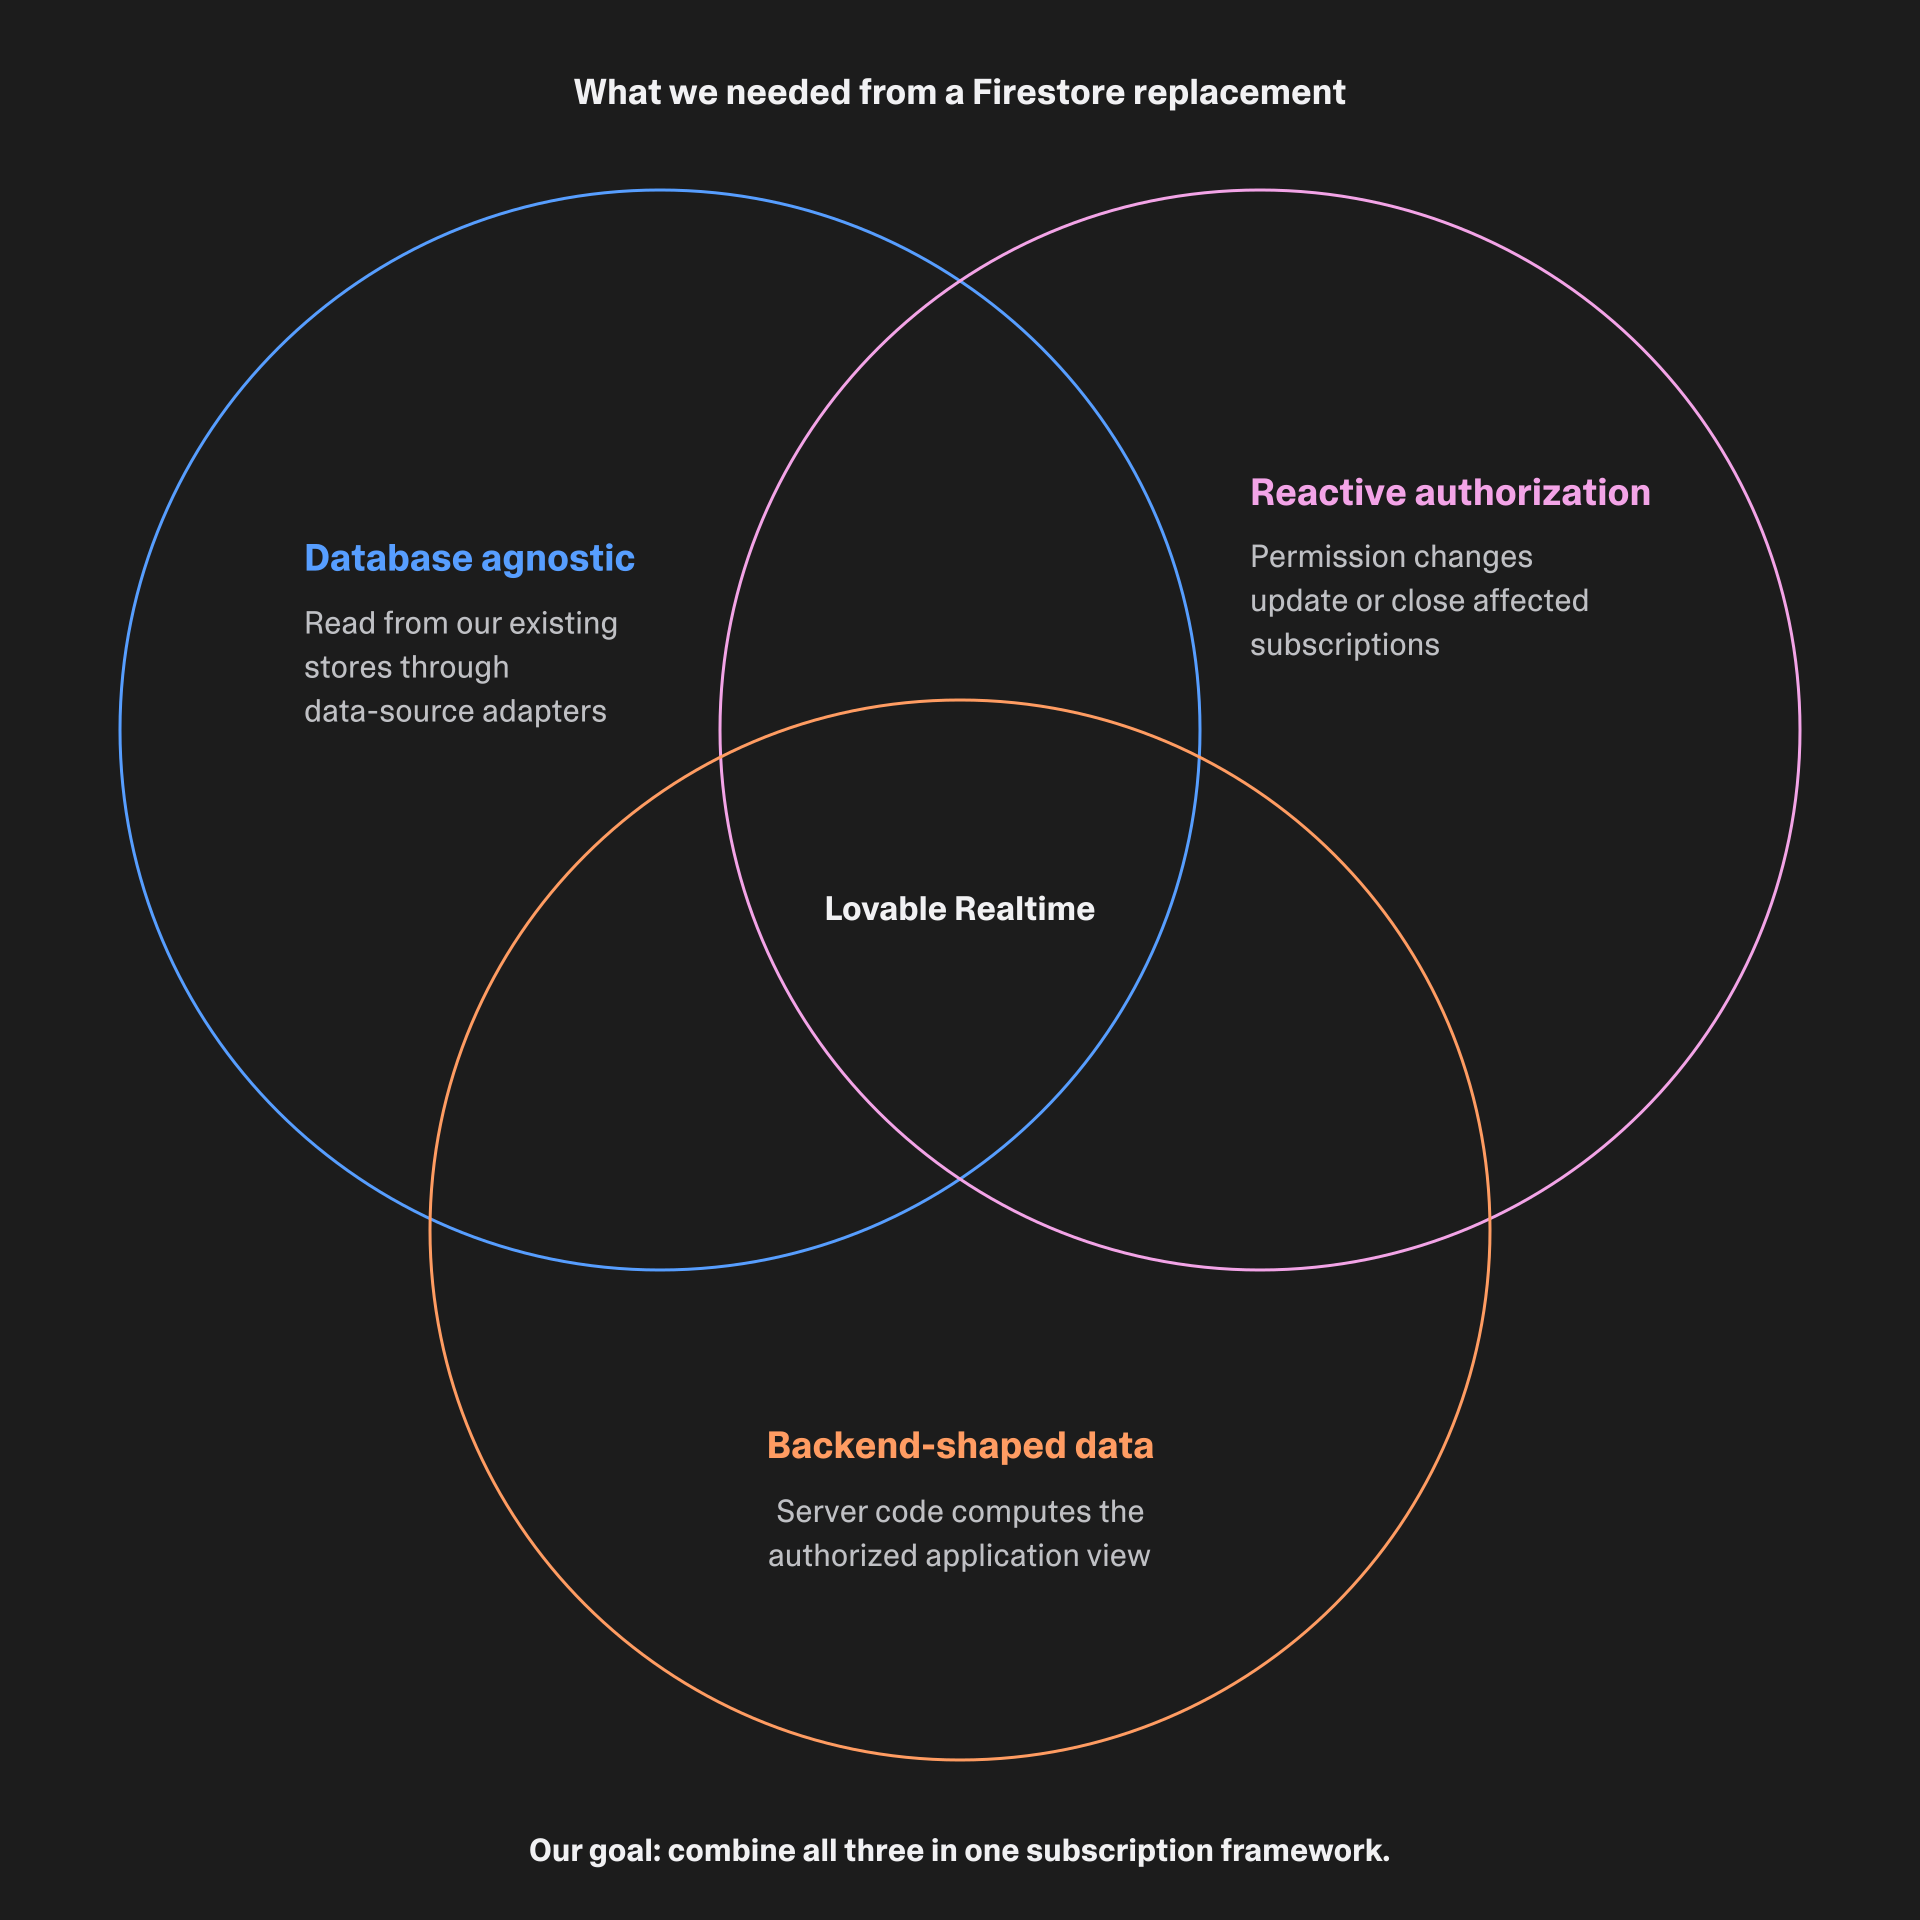
私たちに必要だったのは、既存データベースのサポート、バックエンドで整形されたペイロード、リアクティブな認可の3つを同時に満たすことでした。他の選択肢は、データベーススタックの変更が必要になるか、その仕組みの大部分を自分たちで構築しなければならないかのどちらかでした。ここでは、そうしたトレードオフをどのように評価し、サービスをどう構築し、ユーザーを切り替える前に移行をどうテストしたかを紹介します。
Firestoreの課題
これまでLovableの一部では、ブラウザから直接FirestoreのonSnapshotリスナーを開いてリアルタイム更新を処理していました。この方式にはいくつかの問題があります。まず、認可の経路が2つできてしまいます。FirestoreルールはGolangで書かれたAPIの権限モデルを写したもので、両者の同期を常に忘れないようにする必要がありました。加えて、ブラウザは呼び出しのたびにFirestoreドキュメント全体を読み込みます。つまり、データベースにフィールドを追加する人は、必ずしもそれを意識しないまま、ブラウザに何を公開するかを決めていることになります。これは表面化していないものの、深刻なリスクでした。
さらに、Firestoreの認可ルールには、Firebaseのデータしかクエリできないという制約があります。これは、大規模なグループ向けの認可更新(たとえば、社内のエンジニアリンググループ全員にプロジェクトへのアクセス権を付与する機能)を実現しようとした際に大きな障害となりました。エンタープライズ企業は、ユーザーとグループをLovableのワークスペースに同期するSCIM機能を利用しています。SCIMのような機能には大規模なDBトランザクションと複雑なクエリパターンが必要ですが、Firestoreのようなドキュメント型DBは従来、Spannerのようなソリューションと同じ水準ではそれを提供していません。しかし、Firestore Security RulesはSpannerを読み取ることができません。
私たちは一時的な回避策として、ビジネスおよびエンタープライズのお客様に限り、onSnapshotサブスクリプションをGo API経由でプロキシする方式を導入しました。これによりAPIの権限システムを再利用できましたが、プロキシはクライアントごとのデータ依存関係に対して個別にFirestoreリスナーを開いていました。
数百万件のライブサブスクリプションの規模では、これは数百万本の長時間維持されるアップストリームのストリームを抱えることを意味し、同じデータを何度も重複して監視することも少なくありません。これらのストリームはAPIが共有するFirestore接続プールの容量も消費し、通常のデータベースリクエストと競合していました。別のプールを用意すればこの競合は切り離せますが、クライアントごとにリスナーが増え続ける問題は解決しません。これが一時しのぎであることはわかっていたため、私たちは新たな解決策を探し始めました。
要件と検討した選択肢
Firestoreからの移行を検討するにあたり、主な要件は3つありました。1つ目に、データはFirestoreとSpannerにあり、新しいプライマリデータベースへの移行は避けたいと考えていました。つまり、すでにあるデータストアで動作し(将来的に新しいデータストアも追加できる)ソリューションである必要がありました。2つ目に、認可を継続的に再評価する必要があります。接続が開いている間にも認可が変わりうること、そしてアクセス権を取り消されたユーザーのストリームはセッションの途中でも閉じられることが求められます。そして3つ目に、バックエンドが権限を管理し、サーバーコードでペイロードを整形する必要があります。呼び出し元に権限のないフィールドは、決してサーバーの外に出てはなりません。
それぞれの要件を満たす選択肢は見つかりましたが、評価したソリューションの中に、既存のデータストアとGoバックエンドで動作しながら3つの要件すべてを満たすものはありませんでした。
Ably、Pusher、PubNub、Centrifugoなどのトランスポートサービスは、接続、配信、取り消しの仕組みを提供しています。ただしその場合でも、変更検知、影響を受けるサブスクリプションの追跡、認可済みのプロジェクションは自分たちで構築する必要があります。
Replicacheでは独自のバックエンドを持ち込めます。通知を受けたクライアントがプルを行い、サーバーがそのクライアント向けの認可済みビューを計算する仕組みです。それでも、通知のルーティング、サーバー側のビュー、そして変更追跡(権限の変更のみによって生じるペイロードの変化を含む)は自分たちで実装する必要があります。
Firestore、Firebase RTDB、Supabase Realtime、Hasura、PowerSync、Zeroといったデータベース統合型のシステムは、それぞれがサポートするスタックの範囲内で、ライブクエリ、プロジェクション、認可をさまざまな組み合わせで提供しています。私たちに必要だったのは、既存のFirestoreとSpannerのデータの上に置くデータベース非依存のレイヤーであり、結果をGoバックエンドで計算し、認可の依存関係が変わったときにアクセスを再評価できるものでした。これらのプロダクトでは、大がかりな統合作業なしにその組み合わせを実現することはできませんでした。
ElectricはPostgresのデータの一部をクライアントに同期します。これを使うには、既存のデータストア上に直接構築するのではなく、FirestoreとSpannerのデータをPostgresへ移行または複製する必要がありました。
Meteorのパブリケーションはサーバーコードでユーザーごとのペイロードを整形しますが、リアクティブ性はMongoDBを中心としています。リアクティブなデータとは別に読み込む権限の依存関係は、明示的に処理する必要があります。Convexは私たちが求めていたものに近く、サーバー関数がそのままサーバー側で整形されたリアクティブなサブスクリプションになりますが、Convexのデータベースを使う必要があります。
そこで私たちは、データを新しいストアに移すことなく、データの依存関係、権限の変更、バックエンドで計算されたサブスクリプション結果を結びつける仕組みを自ら構築しました。
構築したもの
Lovable Realtimeは、ライブデータをストリーミングする専用のWebSocketサービスです。認可とデータの形の決定は、Goで書かれたサーバー側で処理します。WebSocketはタブごとに1本で、すべてのサブスクリプションをその接続上で多重化しています。データベースの変更は変更データキャプチャ(CDC)を通じて流れ、影響を受けるサブスクリプションが自動的に再計算されて更新がプッシュされます。データベースに書き込むコード側で、サブスクリプションの更新を手動でトリガーする必要はありません。各ユーザーが何を閲覧できるか、どのフィールドを秘匿するかは、APIと同じ権限フレームワークを使ってバックエンドが制御します。
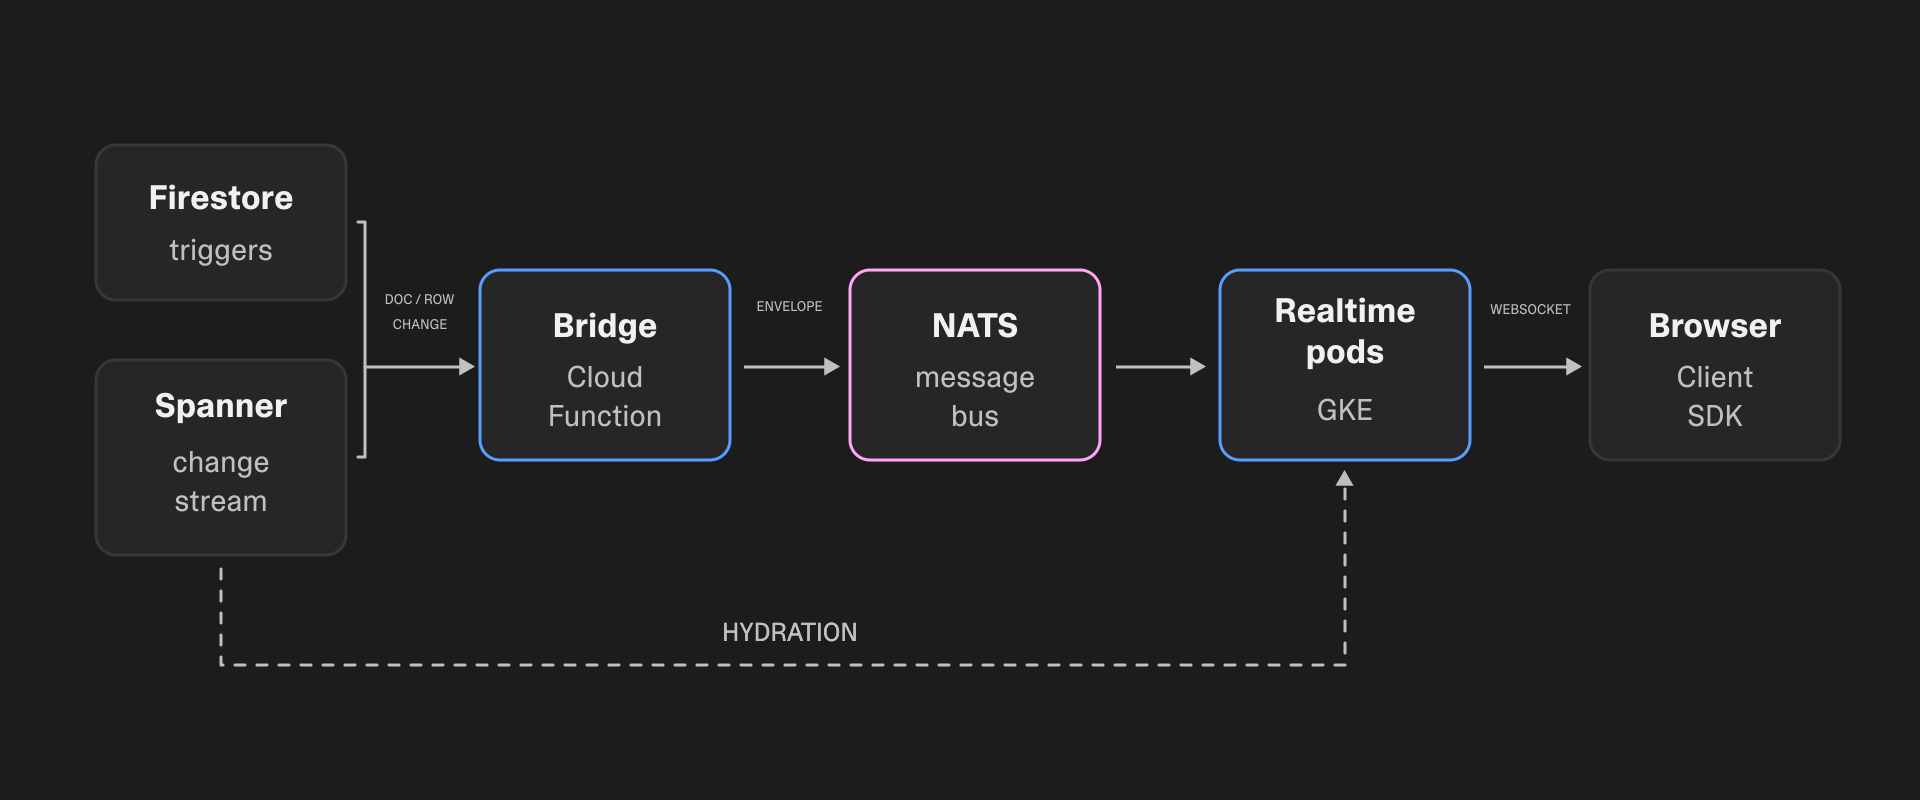
リアルタイムサービスは、GKE上でGoで動いています。各Podは1本のNATS接続と数千のWebSocket接続を保持します。データ変更イベントはFirestoreとSpannerからブリッジに送られ、そこからNATSにパブリッシュされます。NATSメッセージが届くと、Podはそれを一致するすべてのサブスクリプションインスタンスにディスパッチします。各インスタンスはデータプロジェクションを再評価し、xxh3-128ハッシュで重複を排除したうえで、出力が変化していれば差分をフロントエンドにプッシュします。
pub/subにNATSを採用
このサービスでは、メッセージバスとしてNATSを使っています。NATSはRedis pub/subやValkey pub/subに似ていますが、いくつかの利点があります。まず、階層的なワイルドカードサブジェクト(rt.data.workspace.W.project.*)をサポートしており、サーバー側でトライ木を使ってマッチングされます。一方、RedisのPSUBSCRIBEはパブリッシュのたびにパターンリストを走査しますし、シャード化されたpub/subではパターンのサポート自体がなくなります。
NATSのワイルドカードを使えば、パブリッシャーは特定の1つのサブジェクトに書き込むだけで、サブスクライバーは必要な粒度を自分で選べます。7つのチームが約40種類のサブスクリプションを所有している私たちのユースケースには、これがうまく合っています。また、集約チャネルへのマルチパブリッシュという問題も避けられます。この方式では、誰かが将来サブスクライブしうるあらゆる粒度をパブリッシャーが把握していなければならず、集約チャネル自体もすぐに過負荷になりがちです。たとえばシャード化されたRedisでは、ワークスペース全体のチャネルが、そのワークスペースのすべてのイベントを1つのシャードに集中させてしまうことがあります。
NATSは、スケーラビリティのための関心ベースのクラスタールーティングもサポートしています。メッセージは、一致するサブスクライバーを持つノードにだけ送られます。これに対し、従来のRedisクラスターのpub/subは、すべてのメッセージをすべてのノードにブロードキャストします。
開発者体験
バックエンドのフレームワークとフロントエンドのSDKを用意しています。フロントエンドでは、サブスクライブしたいサブスクリプションの名前とパラメーターを渡すだけです:
const { data, status, error } = useSubscription("project", { projectId });
パラメーターとペイロードはGoの構造体から生成されるため、エンドツーエンドで完全に型付けされています。複数のコンポーネントが同じ対象をサブスクライブすると、サーバー側の同じサブスクリプションが自動的に共有されます。SDKはバックオフ(とジッター)付きの再接続も処理し、認証トークンのリフレッシュフレームをサーバーに送信します。
バックエンドでは、エンドポイントを書くのと同じ感覚でサブスクリプション関数を書きます。パラメーターを取得し、アクセス権があることを確認し、目的のレスポンスオブジェクトに変換して返すだけです。
簡略化した疑似コード
func projectSub(call) {
  p := call.Params
  perms := requireAccess(call, ViewProject)
  project := get(Project, p.projectID)
  return toDTO(project, perms.has(ViewProjectUsage))
}
内部では、この関数で使ったデータのいずれかが変更されるたびに、フレームワークが関数を再度呼び出して新しい値を返します。出力は前回の出力とハッシュで比較され、異なっていれば差分がフロントエンドに送られます。
サブスクリプションはFirestoreとSpannerにクエリを実行し、その結果を1つのライブビューにまとめて、呼び出し元がアクセスできるフィールドだけを公開できます。基になるデータや権限が変わると、フレームワークがそのビューを再計算し、変更をクライアントにプッシュします。
可観測性を確保するため、すべてのサブスクリプションは所有チームを宣言する必要があり、宣言がなければ登録に失敗します。各サブスクリプションはAPIエンドポイントと同じように扱われ、アラートはそのデータを所有するチームに届きます。
リアクティブデータソース
では、前の例で取得している「プロジェクト」とは何でしょうか。これは私たちがリアクティブデータソース(RDS)と呼んでいるもので、サブスクリプションの基盤となっています。
簡略化した疑似コード
Project = RDS[Project]{
  Query: func(ctx, p) {
    return db.GetProject(p.id)
  },
  Subjects: func(p) {
    return []string{"rt.data.project." + p.id}
  },
  Apply: func(cached, ev) {
    if ev.deleted {
      return nil
    }
    return decode(ev.data)
  },
  TTL: 5 * time.Minute,
}
上のコードからわかるように、RDSは基本的に次の3つを抽象化したものです:
データをどのように取得するか(クエリ関数)
そのデータの更新をどこから受け取るか(NATSサブジェクト)
そのデータの更新を受け取ったときに何をするか(これがapply関数で、変更内容を整合させるリデューサーのように機能します)
各データソースにはTTLも設定できます。TTLとは、ソースに再度クエリせずにキャッシュ済みのデータを再利用できる期間の上限です。TTLを過ぎると、キャッシュされたスナップショットは提供されなくなり、次の読み取りでは信頼できる唯一の情報源に対してクエリが再実行されます。
この例はとてもシンプルです(1つの対象だけを監視するポイントルックアップ)が、「ワークスペース内でアクセス数の多いプロジェクトのトップ10」のような複雑なRDSを作ることもできます。
認可もRDSの1つ
認可自体も、RDSの1つにすぎません!認可プロバイダーを呼び出して権限セットを取得し、設定やACLなどの変更を監視します。
当初は、アクセス判定に関わるドキュメントが変わるたびに権限を再計算していました。これにはプロジェクトのドキュメントも含まれます。しかし、プロジェクトのドキュメントはファイルを編集するたびに変わるため、プロジェクトのサブスクリプションが更新されるたびに権限の完全な再計算が走っていました。
解決策は、受信したドキュメントとキャッシュ済みのドキュメントを比較し、アクセス判定に使われるフィールドが変わったときだけ再計算することでした。これにより、再計算は約84%減りました。権限評価では明示的なフィールド比較を維持しており、静的解析テストが、対象とする権限判定パッケージ内でエントリの漏れや古いエントリがないかをチェックしています。これらの比較は認可ロジックの一部であり、権限チェックそのものと同じだけの注意を払う必要があります。
サブスクリプションシミュレーター
まずはワークスペースの例から始めてみてください。サブスクライブしてから、ワークスペース名を変更したり、権限を変更したり、内部フィールドを更新したりして、何がクライアントに届くかを確認できます。次に、最新10件のプロジェクトを取得するライブクエリや、SpannerとFirestoreのデータを組み合わせたプロジェクト概要を試してみましょう。シミュレーターでは、スナップショット、パッチ、重複排除、再接続時の再利用がどのように機能するかを確認できます。
インタラクティブなリアルタイムシミュレーターを新しいタブで開く。
ロールアウトと運用
まずシャドートラフィックを使い、その後約1週間かけて段階的にサービスを有効化しました。シャドーモードでは、フロントエンドが新しいサービスをサブスクライブして全経路を実際に動かしつつ、ペイロードは破棄し、表示は引き続きFirestoreから行っていました。これにより、サービスが受けることになる実際のトラフィックやデータの姿に加え、9日間開きっぱなしのタブのようなエッジケースも把握できました。
このシャドーローンチによって、デプロイ後の再接続ストーム、エラーの誤分類、ペイロードの上限が実データに対して小さすぎたことなど、複数の問題を見つけて修正できました。
フィーチャーフラグを使った実験的なロールアウトを行い、数日かけて対象ユーザーを1%、10%、50%、そして最終的に100%へと拡大しました。ロールアウト中にインシデントは発生せず、監視していたロールアウト指標にも劣化は見られませんでした。
長時間維持されるWebSocket接続をKubernetes上で運用すると、スケーリングの通常の前提が変わります。まず、数分から数時間続くソケットにラウンドロビンの負荷分散は適さないため、代わりに接続数に基づいて分散しています。また、接続はスティッキーなので、スケールアウトしても負荷の高いPodは楽になりません。1つのPodが落ちたり入れ替わったりしても大規模な再接続の波が起きないよう、Podあたりの接続数は意図的に制限しています。メモリには余裕を確保し、接続数、CPU、メモリに基づいてスケールさせ、再接続の頻発を抑えるためにスケールインは控えめにしています。
デプロイのたびに大量の切断が発生するため、デプロイの仕組みは実質的に「群れの管理」です。カナリアリリースは10%刻みで約4分ずつ間隔を置き、WebSocketアップグレードの成功率、アップグレードのレイテンシ、Podの再起動、サブスクリプションのサーバー障害率をゲート条件にしています。フロントエンドのSDKは、デプロイ後の再接続を20秒間に分散させます。再接続時、クライアントはキャッシュしている状態のフィンガープリントを送信します。サーバーは認可を再確認して現在のデータを読み込んだうえで、状態が変わっていないことを確認できるため、再送信やクライアントでの不要な再レンダリングを避けられます。
成果と今後の展望
この変更により、フロントエンドでFirestoreを使用することは一切なくなりました。
以下の測定値は2026年9月5日から2026年10月5日までの期間を対象としており、開始・終了ともに00:00 UTCを区切りとしています。同時接続のライブサブスクリプション数はピーク時に206万に達しました。この1か月間にサービスが配信したデータフレームとパッチフレームは26.1億件で、1日平均8,690万件です。なお、再開時の制御フレームは含みません。
この30日間で、計算したすべての結果を完全なスナップショットとして送信していた場合、アプリケーションペイロードは推定40 TBに達していたはずです。ハッシュベースの重複排除により、ペイロード評価の88.4%が抑制されました。ペイロードサイズの違いを考慮すると、これによりバイト数の約80%を削減でき、完全なスナップショットを基準とした量は8.20 TBまで減ったと推定しています。
変更があった更新については、差分を送信することでペイロード量が94.5%削減されました。初回のサブスクリプションと再接続時には引き続き完全なスナップショットを使用しているため、合計は2.24 TBでした。さらに、再接続時に変更のない状態を再利用することで、実際に送信したペイロードは1.11 TBまで減少しました。これは、計算したすべての結果を完全なスナップショットとして送信する場合と比べて、全体で推定97%の削減にあたります。これらの数値はアプリケーションペイロードを測定したもので、プロトコルやトランスポートのオーバーヘッドは含みません。
サブスクリプション開始の成功率は、記録されたすべての結果で99.85%、想定内の拒否と接続キャンセルを除くと99.9975%でした。これとは別に、WebSocketハンドシェイクの成功率は、すべての結果で99.93%、想定内の拒否を除くと99.99916%でした。
ソースデータベースへの書き込みから、フレームが送信可能になるまでの更新レイテンシは、p50で66 ms、p95で178 ms、p99で249 msでした。これらの数値には、ソケットへの書き込み、ネットワーク、クライアント側の処理は含まれていません。
とはいえ、最大の成果は定性的なものです。認可とデータの形をバックエンドが管理するようになりました。アクセス権は一元化された監査可能なルールに基づいて継続的に再確認され、Firestoreのルールエンジンが原因で実現できなかったエンタープライズ向け機能も、今ではすべてのユーザーが問題なく使えるようになっています。
同様の仕組みを構築しようとしているチームに向けて、私たちが得た教訓をいくつか共有します:
ユーザーを切り替える前にシャドートラフィックを使う:実際のトラフィック、データの形、ユーザーの行動を本当に反映した負荷を生み出せる方法は、私たちにとってシャドーモードしかありませんでした。それこそがロールアウトを成功に導いた要因だと考えています。
あえて弱い配信保証を選ぶ:必要のない保証をすべて切り捨てることで、アーキテクチャをシンプルにしました。UIのスナップショットには、順序どおりの配信も、厳密に1回だけの配信も必要ありませんでした。最終的に必要だったのは、TTLとサブジェクトごとのウォーターマーク(順序が入れ替わって届いたデータを無視できる仕組み)だけでした。
フレームワークのシンプルな使い方を、そのまま唯一の使い方にする:私たちのSDKでは、作成者はAPIエンドポイントを書くような感覚で関数を書き、利用側はわずか2行を書くだけで、それ以外はすべてフレームワークが担います。また可能な限り、人(あるいはエージェント)が何かを正しく行うことを覚えているかどうかに頼らないようにしています。Goの構造体からエンドツーエンドですべてに型が付いており、ずれを検出するCIチェックも用意しています。現在、7つのチームが約40種類のサブスクリプションを所有しており、各チームが誰の手も借りずに独自のものをリリースしています。
スナップショットを全レイヤーで使い、差分は通信時だけにする:フレームワークのすべてのレイヤー(ハイドレーション、イベントのマージ、サブスクリプション関数、ハッシュによる重複排除)はデータのスナップショットを扱います。スナップショットが差分に変わるのは、ソケットに渡す直前の最後のステップだけです。これにより、先に説明した通信量の削減を実現しつつ、完全なデータスナップショットを、どこでも同じように考えられる単一の表現として扱えます(不正な状態に陥ったフロントエンドを修復するのにも使えます)。
システム全体を検証できるテストハーネスをコーディングエージェントに与える:私たちの統合テスト環境には、Firestore、Auth、Spannerのエミュレーターに加えて組み込みのNATSサーバーが含まれており、Authエミュレーターが発行した本物のIDトークンを使用します。私はアーキテクチャとエッジケースを詰めたうえで、実装の大部分をコーディングエージェントに任せました。このハーネスのおかげで、エージェントはフルスタック全体で変更をテストできました。
今後の取り組みについてです。フレームワークはデータスナップショットに最適化されていますが、データスナップショットは不要で、何らかのイベントが発生したことだけを知りたい場面もあります。これはRDSプリミティブでも実現できますが少し扱いにくいため、現在、ドメインイベントのプリミティブをアーキテクチャに追加する取り組みを積極的に進めています。
フロントエンドはもうFirestoreに依存していません。今後データベースの選択がどう変わっても、バックエンドが認可とペイロードを制御したまま、各チームはより豊かなリアルタイムコラボレーションを構築できます。このサービスは、将来的にLovableで作られたアプリで利用できる機能になるかもしれません。
Lovableでこうしたプロジェクトに携わることに興味がある方は、ぜひ募集中の職種をご覧ください。私たちは現在採用中です!