Lovableをシンプルで信頼できるものにするために、私たちはその仕組みを何度も考え直してきました。技術の状況が変わり続ける中で、かつては役立ったエンジニアリング上の選択が、やがて足かせになることがあります。AIを活用したプロダクトを開発する多くのチームが、同じ問いに直面しています。何を残し、何を作り直すべきなのか、という問いです。
2023年春、私はGPT EngineerというオープンソースプロジェクトをGitHubで公開しました。作りたいソフトウェアを説明すると、内容を確認する質問をしたうえで、コードベース全体を書き上げるというものです。同じ年の後半、私はLovableの計画を書き留めました。コードを書けない人でも、チャットを通じてソフトウェアを作成・デプロイ・改善し、その結果をすぐに確認できるようにする、という計画です。それから私たちのコードベースで10万件を超えるプルリクエストを重ね、共同創業者のFabianと、エンジニア、デザイナー、プロダクトマネージャーからなるチームが、その計画をLovableとして形にしてきました。これまでにユーザーがプラットフォーム上で作成したプロジェクトは7,000万件を超えています。
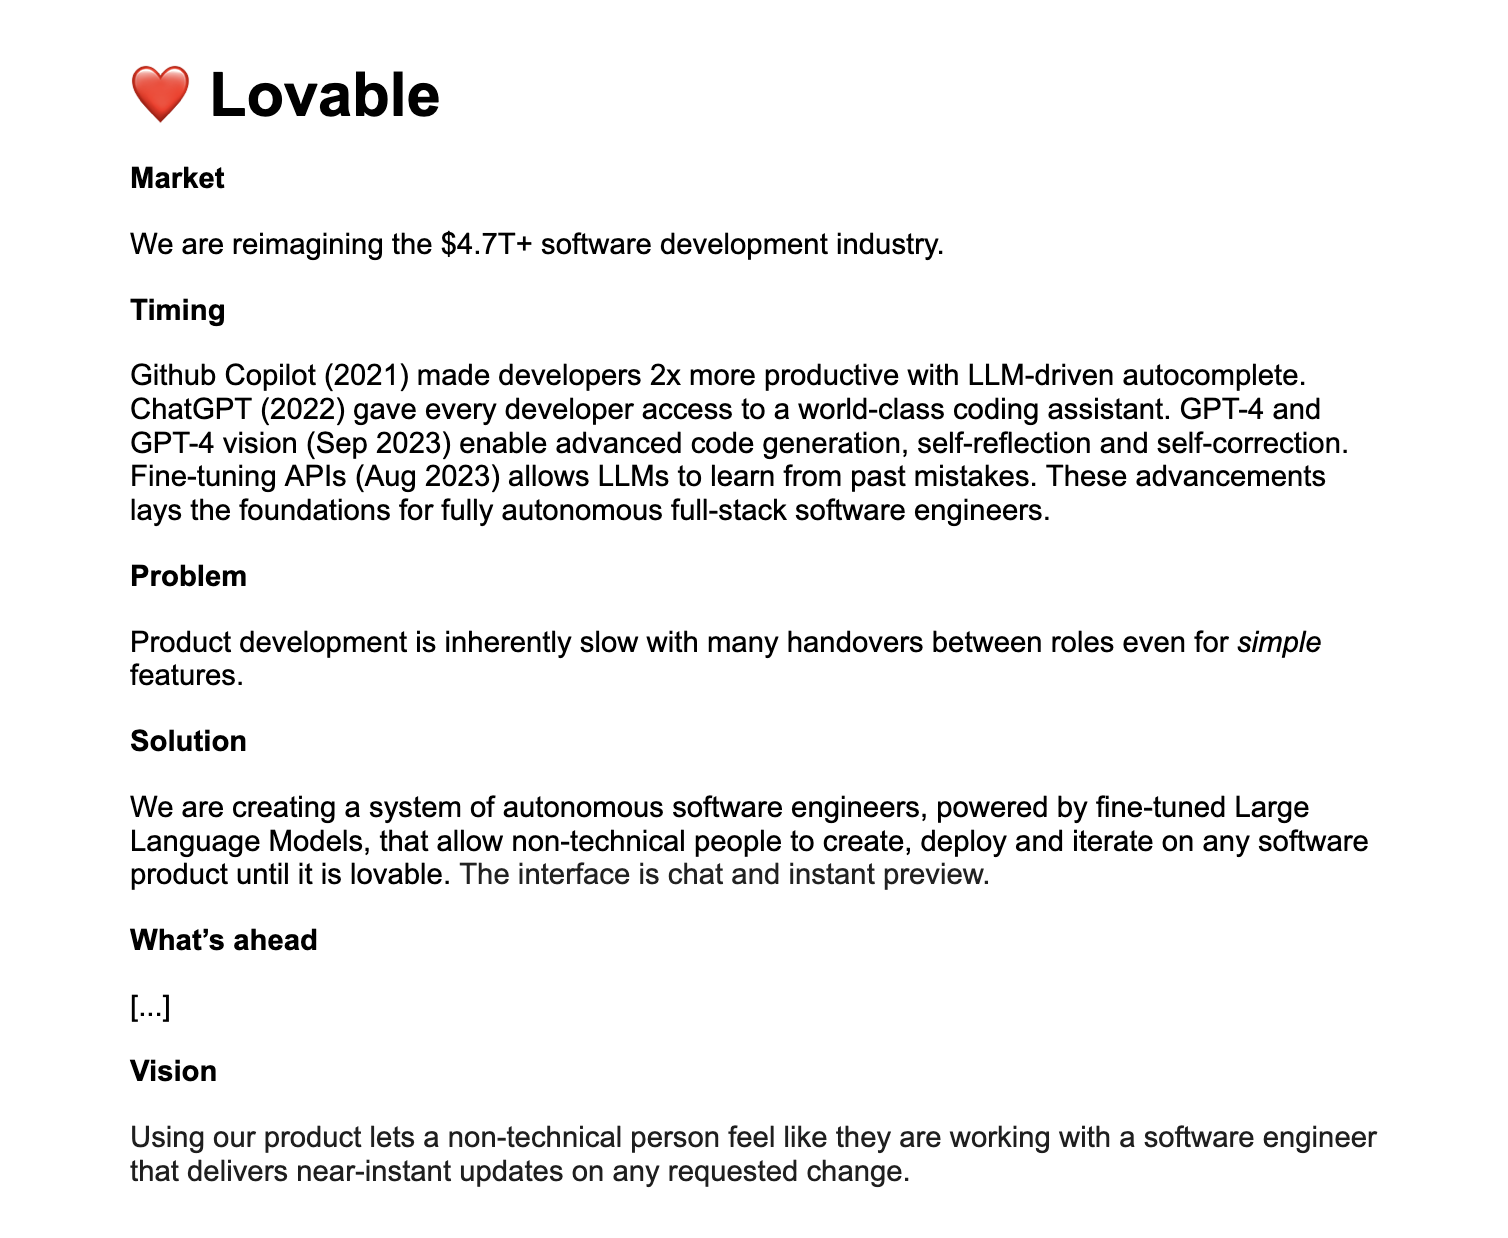
最近、当初の計画を読み返してみたところ、最終的に作り上げたものと驚くほど似ていました。予想していなかったのは、そこにたどり着くための方法を何度も作り直すことになった点です。その過程で、モデルにどれだけの自由を与えるか、モデルのミスをいかに素早く見つけるか、さらにはモデルが作業しているコンピューターそのものをどうフォークするかまで、考え直す必要がありました。
ソフトウェアプロダクトを開発している他のチームも、同じような課題の多くに取り組んでいるのではないかと思います。私たちがそれらにどう向き合ってきたかを共有することで、その取り組みが少しでも楽になれば幸いです。
問題を絞り込んだことが先行につながった
私たちは、新しいアプリケーションの作成を支援することにしました。ユーザーがアイデアを持ち込み、Lovableがコードベースを生成して、ワンクリックでホスティングまで行うという形です。新規(グリーンフィールド)プロジェクトに絞ったことで、既存のコードベースや依存関係、環境の膨大な多様性に対応せずに済みました。さらに、技術スタックをあらかじめ決めることで問題を絞り込み、初期にあったフロントエンドのスタックを選べるセレクターも廃止しました。
こうした選択が組み合わさることで、使用するライブラリ、コードの構造、そしてコードが動く環境を私たちがコントロールできるようになりました。生成されたコードを自分たちが理解している環境で実行し、失敗を調べ、システム全体を自動的に改善できたのです。その共通の環境に加えた改善は、多くのプロジェクトに効果を及ぼしました。
原則はシンプルでした。問題を絞り込み、実行をコントロールし、その結果から学ぶことです。
エージェントの自由度をモデルの能力に合わせる
アプリケーションを画面に表示させるのは、ひとつの段階にすぎませんでした。変更の依頼が次々と続く中で、それを動かし続けるほうがずっと難しかったのです。
開発者なら、壊れたアプリケーションを調べてコードを修正できます。一方、プログラミングの経験がまったくない人には、そうした作業のはるかに多くをプロダクトが代わりに担う必要があります。
モデルは急速に進化すると見込んでいたので、私は自律型エージェントの方向へチームを押し進め続けました。将来のモデルを見据えて開発したかったのです。エンジニアのMårten Wimanはこれを非常に高度な非同期設計にまで発展させ、エージェントがタスクを作成してサブエージェントに委任できるようにしました。しかし、制約の少ないエージェントは技術的な深みにはまり込み、エラーを起こしたり、いつ終わるか予測できない行動を取ったりしました。自由を与えるほど、プロダクトの信頼性は下がっていったのです。
そこで私たちは一歩引きました。エージェントのコードをほぼすべて削除し、1つのユーザーリクエストから比較的予測しやすいツールの連鎖が実行され、その出力をチャットとライブプレビューで確認できる形に戻したのです。2024年後半には、メインの編集フローは、依頼されたファイル変更を含む単一のレスポンスになっていました。当時はネイティブのツール呼び出しが十分に信頼できなかったため、モデルにコードを<lov-write>のようなXML風のタグで囲ませ、エージェントの処理が終わった後に編集内容をパースしていました。
リトライやエラー処理はありましたが、モデルがツールを実行し、結果を確認し、次の一手を選ぶという制限のないループはありませんでした。ユーザーはプレビューで結果を確認し、次の変更の方向を決めることができました。
モデルには、一度に扱えるコードの量にも限りがありました。アプリケーションが大きくなるにつれ、モデルに何を見せるかを選ぶこと自体がひとつの課題になりました。私たちはファインチューニングした小型のLLMを使って、各変更が依存するコード(編集の必要がないファイルも含みます)を特定し、そのコンテキストをコーディング用のモデルに渡していました。
私たちは、モデルに何ができるか、そしてモデルに何が見えるかの両方を形づくる方法を学んでいたのです。
モデルを学習させる計画でした。ナレッジファイル+RAGのほうがうまくいきました。
適切なコードを選ぶことは、コンテキストの問題の一部にすぎませんでした。ユーザーが開発を進める中で、同じミスが繰り返し起きていることに気づきました。2023年の計画では、Lovableはプロダクトが生み出すデータで学習したファインチューニング済みモデルで動き、失敗した試みのひとつひとつがシステムを改善していくはずでした。
2024年、私たちはもっとシンプルな始め方を見つけました。エンジニアが壊れたアプリのチャットログを調べ、繰り返し起きるミスとその回避方法を説明する短いメモを書いたのです。
私たちはこれを「ナレッジファイル」と呼びました。たとえばアイコンの問題なら、次のようなシンプルな指示になります:
# Icons
Only use icons that exist in lucide-react.
Never invent an icon name. If unsure, pick a generic one.
ナレッジファイルの例(説明用)。
検索(リトリーバル)ステップで関連するメモを選び、モデルのコンテキストに追加しました。ファインチューニングは不要で、使うのはテキストだけです。現在エージェントスキルを使っている人なら、このパターンに見覚えがあるでしょう。役立つ指示をファイルにまとめておき、タスクに関係するものを読み込むという方法です。
この取り組みは、2024年後半に私たちが急成長するうえで決定的に重要だったと考えており、スケーリング則と呼んだほどです。壊れたアプリから得た有益な教訓が、私たちが新しいモデルを学習させるのを待たずに、次のユーザーの助けになりました。
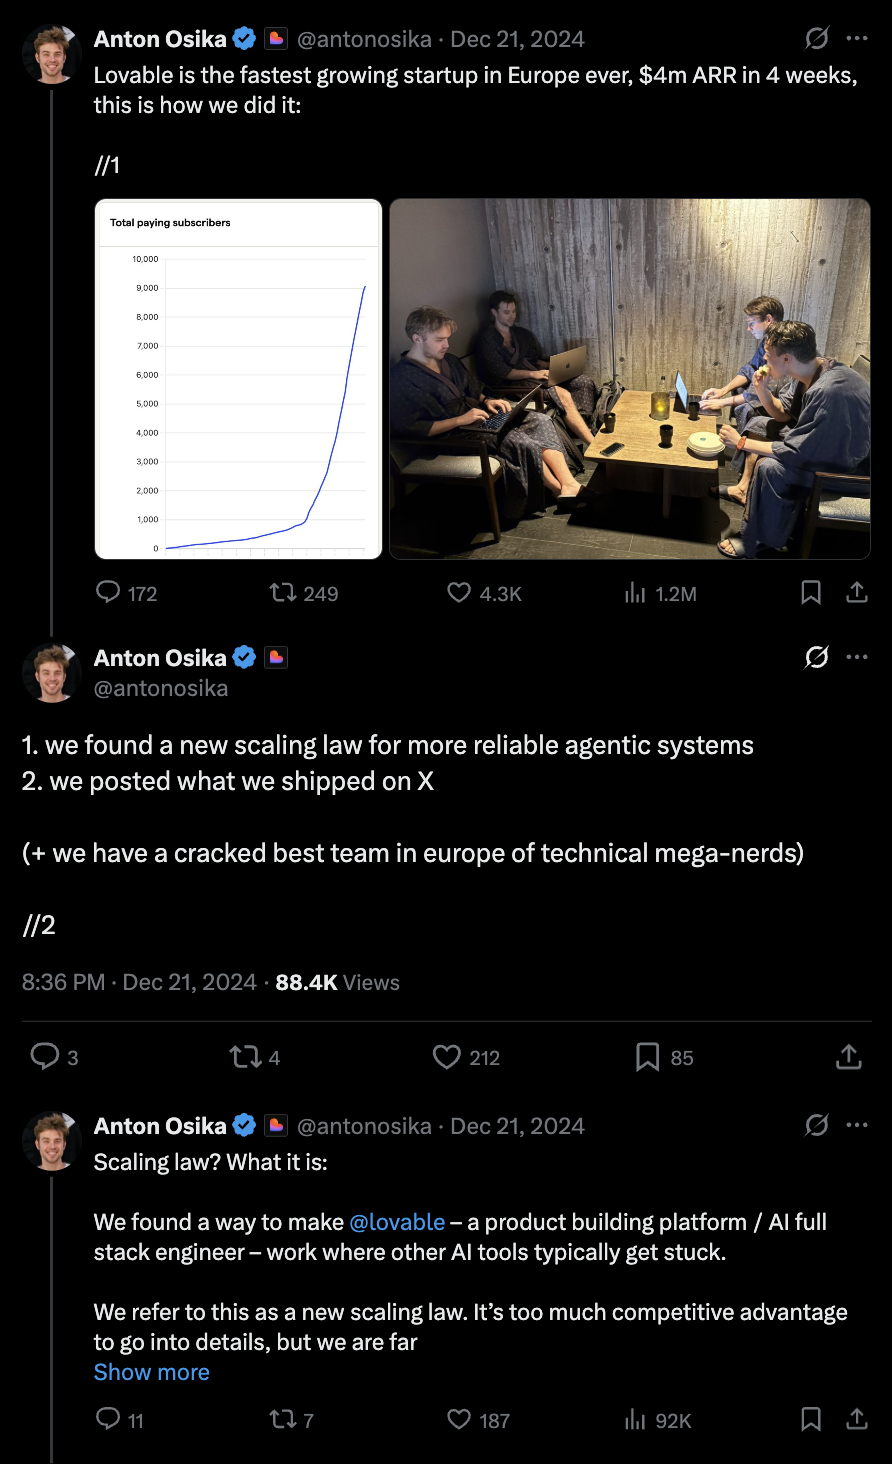
その後、同じ考え方をLovable Stack Overflowにも応用しました。これは、エージェントのために問題と解決策を検索して取り出す仕組みです。初期バージョンでは、ユーザーが行き詰まる割合が5%減少しました。
エージェントのフィードバックループを高速化し、軽快な体験を実現
自分のミスを修正できるエージェントでも、ユーザーはその修正を待たなければなりません。試行のたびにフルビルドが必要なら、小さな変更でさえ時間のかかるやり取りになってしまいます。
私たちは、各プロジェクトのファイルを保持し、ユーザーが作業している間は開発サーバーを動かし続けるサンドボックスを構築しました。これにより、本番用のバンドルを新たに作らなくても、編集内容をライブプレビューに反映できるようになりました。
これとは別に、増分型のTypeScriptチェックが以前のチェック結果を再利用し、コード同士のつながりに関するエラーを検出しました。エージェントはそのエラーをもとに、プロジェクトを動かしたまま修正に取り組めました。
エラーをモデルに返してリトライする仕組みは、すでにありました。このインフラの狙いは、編集・チェック・修正の各サイクルを短くすることです。コーディングエージェントの速さは、自分の作業をどれだけ素早くチェックして修正できるかにも左右されます。編集のたびにこうした高速化が効いたことで、Lovable全体の使い心地が大きく変わりました。
新たな基盤:コンピューターをフォークしてマージする
開発サーバーを動かし続けることで、編集とチェックのサイクルは短くなりました。その後、私たちはさらに一歩進め、エージェントが数日後に戻ってきても、同じ作業環境を数秒で再開できるようにしました。
ソースファイルを保存するだけでは不十分で、実行中のプロセスも保持する必要がありました。私たちのステートフルなサンドボックスは、マシンのメモリ、CPUの状態、ディスクをチェックポイントとして保存し、必要なときに復元します。
この取り組みは、Lovableのさらに多くの技術的な機能の基盤になりました。今ではコードだけでなく、作業環境やデータベースを含むアプリケーション全体をフォークできるようになり、エージェントが同じ出発点から異なるアプローチを試せるようになっています。
編集を速くするための手段として始まったものが、今ではエージェントにはるかに多くのことを任せられるようにしています。
次の10万件のプルリクエストへ
2023年に私たちが作ろうとしていたプロダクトは、今ではWebサイトから高度なフルスタックアプリケーションまで、7,000万件を超えるプロジェクトの構築を支えるまでになりました。ここに至るまでに、私たちはLovableの作り方を何度も根本から作り直してきました。そのひとつひとつの選択が、同じ目標へと私たちを近づけてくれました。アイデアを持つ人が、何にも妨げられることなくそれを形にできる世界です。
しかし、それはまだ簡単な部分にすぎません。
未解決の大きな課題が、まだ3つ残っています。
面倒な作業を自動操縦にする。アプリを作ることは、いつだって始まりにすぎませんでした。実際の顧客や実際のお金がアプリに依存するようになると、あらゆる変更がより難しく、よりリスクの高いものになります。さらに難しいのは、そのライフサイクル全体を担うことです。つまり、本番環境のソフトウェアのテスト、デプロイ、保守を、寝ている間も途切れることなく行い続けることです。スケーリング、稼働率、セキュリティ、そして顧客が気づく前にバグを修正すること。中でも最も難しいのは信頼です。ユーザーのリクエストをひとつ誤解しただけで、データが削除されたり、元に戻せない形で何かが壊れたりする可能性があります。それを防ぐのは私たちの責任です。
あらゆる種類のソフトウェアをシームレスに作れるようにする。デスクトップでもモバイルでも、複雑なワークフローでも、リアルタイムのデータ処理でも、グローバルな業務システムでも、顧客は必要なものを説明するだけで、それが動くべきです。それぞれに異なる環境や制約があり、失敗のパターンも異なります。
より良いソフトウェアスタックを作る。私たちの仕事は、顧客にとってソフトウェア開発をシームレスにすることだけではないと考えています。ソフトウェアスタックそのものを、より良いものへと改良し続けることも私たちの仕事です。それは、新しい基盤を生み出すことを意味します。オブザーバビリティの革新、コンピュータのスナップショットのフォークとマージ、新しい同期エンジン、耐久性のある実行パターン、そしてユーザーのための検証可能なセキュリティとプライバシーの保証。人々が利用するソフトウェアスタックが、最終的に最も役立つ形へと進化するまでには、改善すべきことがまだたくさんあります。
この3つを解決すれば、「AIソフトウェアエンジニア」を超えるものが生まれます。人々がビジネス全体を動かすためのプラットフォームです。ユーザーはすでに私たちをその方向へと引っ張っています。Slackを接続し、自分たちのデータをLovableに取り込み、普段使っているあらゆるツールとLovableを連携させています。会社を運営し、Lovableで決済を処理し、さらにグロースツール、検索での見つけやすさ、アナリティクスといった機能を使って、私たちとともにビジネスを成長させています。Lovableに会社の法人登記まで依頼するユーザーもいるほどです。私たちの仕事は、彼らの大きな目標を阻むものを取り除くために、できることをすべて行うことです。
それこそが、次の10万件のプルリクエストで私たちが取り組むべき仕事です。
教科書に答えが載っておらず、その成果が同じ週のうちに何百万人もの人々の目に届く。そんな難しい課題に取り組みたい方は、ぜひLovableで私たちと一緒に作りましょう。
また、別の場所で同じ課題に取り組んでいる方は、新しく立ち上げた技術ブログを購読してください(2026年に「技術ブログ」なんて書くことになるとは思いませんでした)。私たちのビジョンに向けた取り組みの中で得た学びを、実際に手を動かしているエンジニア自身がお届けします。