AIプロバイダーが上限に達したとき、バックアップに切り替えるのは簡単なことに思えます。しかしAIエージェントの場合、その切り替えによって同じコンテキストを最初から処理し直すことになり、レイテンシやコストが増え、次のプロバイダーへの負荷も高まる可能性があります。
ピーク時のトラフィックが毎分10億トークンを超える中、私たちはその処理能力を無駄にせずにプロバイダーの障害に対応する必要がありました。これが、LovableのLLMプロバイダーロードバランサーの背景にある課題です。
エージェントベースのシステムにおけるロードバランシングは、単に余裕のあるプロバイダーを見つければよいというものではありません。プロバイダーは互換的ではなく、より賢いという理由で特定のモデルを優先したい場合もあれば、同じモデルでもより高速な推論を提供しているという理由で特定のプロバイダーを優先したい場合もあります。さらに、エージェントのリクエストはプロバイダー側でキャッシュされたプロンプトのプレフィックスを再利用できるため、プロバイダーを切り替えるとそのコンテキストを再処理する必要が生じ、レイテンシとコストが増加することがあります。
プロンプトキャッシュと、プロバイダーのロードバランシングが必要な理由
私たちは複数のモデルプロバイダー(Anthropic、Vertex、Bedrockなど)にキャパシティを確保しており、あるプロバイダーがダウンしても他のプロバイダーにフォールバックして、ユーザーへの影響を抑えられるようにしています。素朴に考えれば、順位付けしたリストを作ればよいでしょう。まずメインのプロバイダーに処理できる限りのトラフィックを送り、あふれた分を2番目に回し、以下同様に続けるという方法です。
しかし、第一候補がレート制限エラーを返していて、一部のリクエストは通る一方、残りは第二候補にフォールバックしているという状況を考えてみてください。これはプロンプトキャッシュにとって最悪です。
プロンプトキャッシュは、後続の呼び出しで以前のプロンプトやコンテキストを再利用できるようにすることで、稼働中のエージェントの速度とコストを改善します。Lovableではこれを大いに活用しています。私たちのエージェントは通常、コード生成を始める前にある程度の探索を行い、最初の呼び出しでコンテキストや状態を取得するためです。
プロンプトキャッシュが機能するには、該当するプレフィックスがキャッシュされているプロバイダーにリクエストが届く必要があります。同じプロジェクトのリクエストが複数のプロバイダーに分散されると、キャッシュミスによってコンテキスト全体を再処理しなければならなくなることがあります。
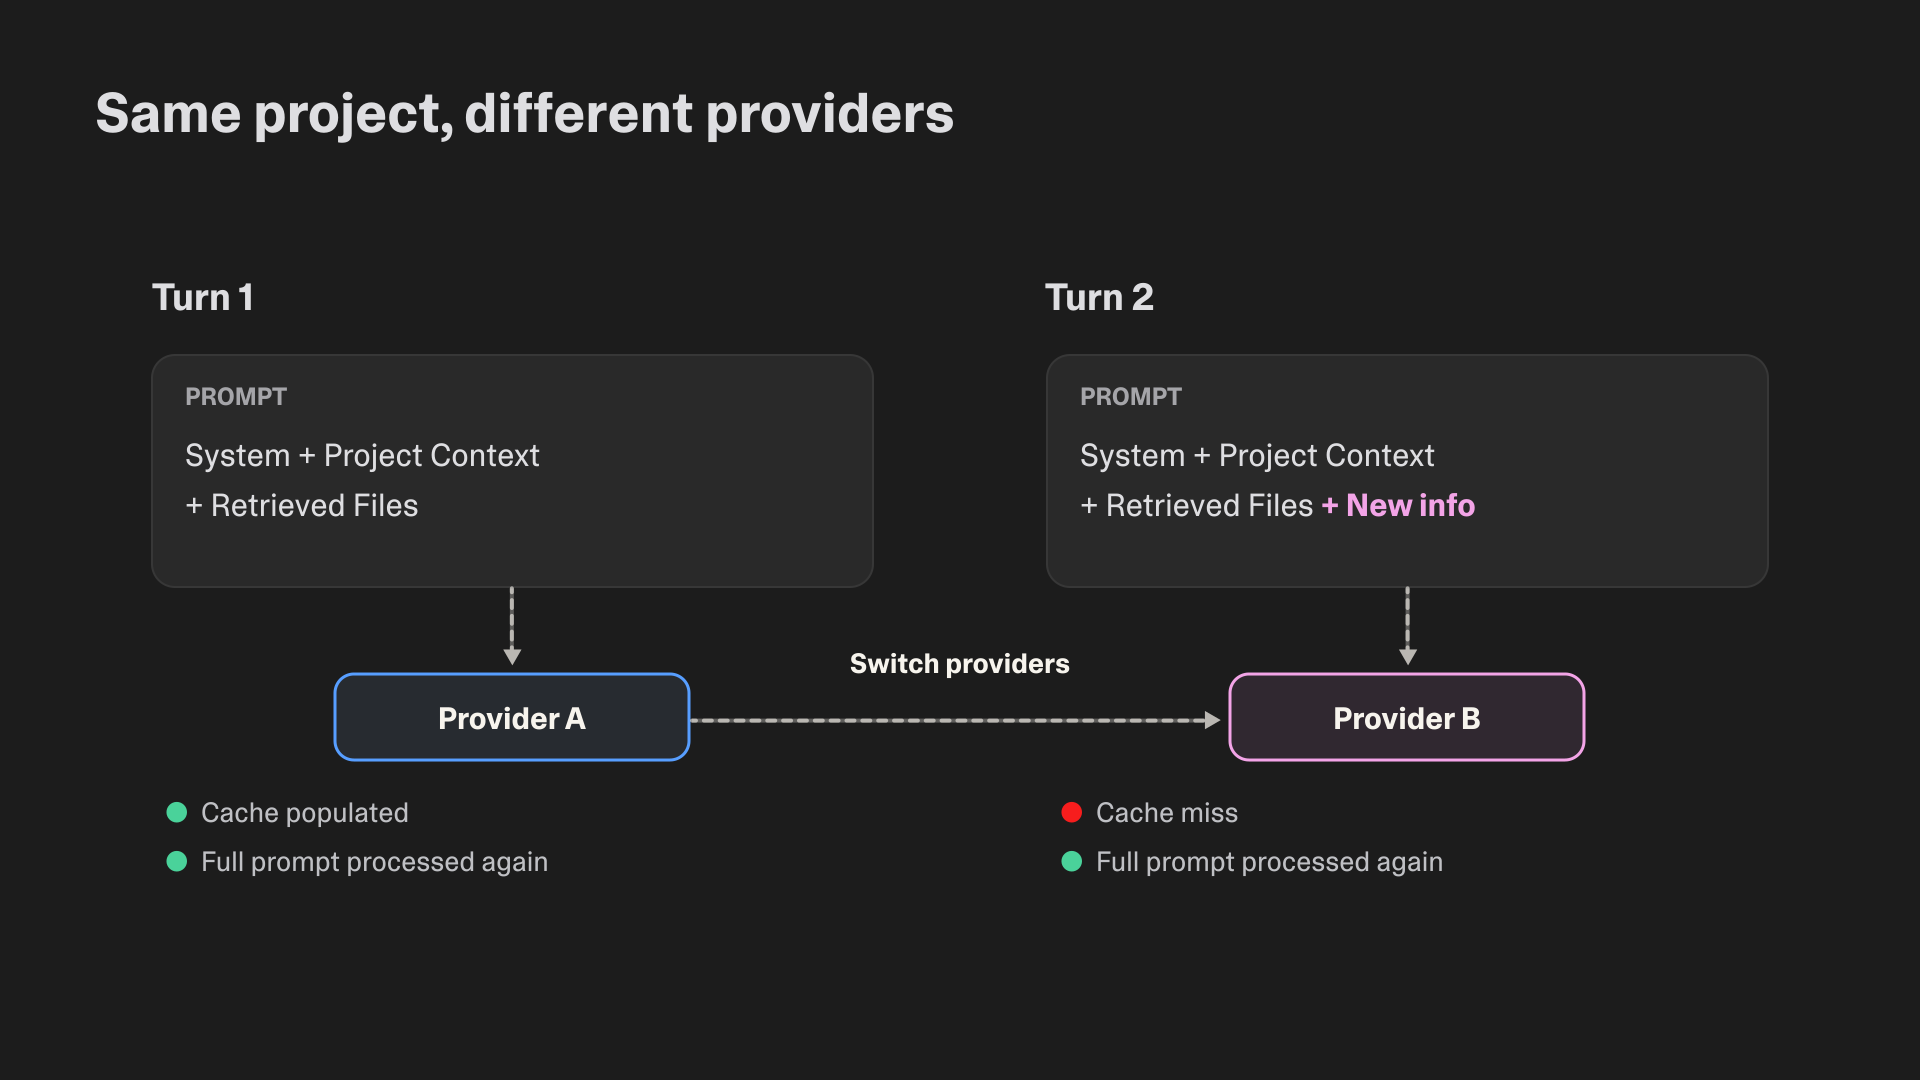
これは非効率でコストもかかりますが、問題はそれだけではありません。LLMプロバイダーが私たちに課すレート制限は、主に送信するキャッシュされていないトークンの数で定義されています。そのため、ここでうまく対処できないと、すべてのプロバイダーのキャパシティを使い果たし、ユーザーにレート制限をかけざるを得なくなるおそれがあります。
そうした事態を防ぐには、単純なフォールバックチェーン(リクエストが失敗した場合に試すプロバイダーの順序付きリスト)だけでは不十分です。各プロバイダーがキャパシティの範囲内に収まるようトラフィックを分散しつつ、同じプロジェクトの連続するリクエストをできる限り同じプロバイダーに送り続けるロードバランシングが必要です。
仕組み:複数のフォールバックチェーンとプロジェクト単位のアフィニティ
障害に対応しながらプロンプトキャッシュを維持するため、私たちは単一のグローバルなフォールバックチェーンには頼りません。代わりに、第一候補となるプロバイダーがそれぞれ異なる複数のフォールバックチェーンを生成します。各プロジェクトにはそのうち1つのチェーンが割り当てられ、短期間はそれを使い続けるため、プロジェクトの連続するリクエストは一貫した経路でルーティングされます。
フォールバックチェーン自体は確率的に構築されます。概念的には、アルゴリズムは次のように動作します:
- 各プロバイダーが受け取るべきトラフィックの割合を表す重みのセットから始めます。
- チェーンの最初のプロバイダーをサンプリングします。各プロバイダーが選ばれる確率は、その重みに比例します。
- 残りのプロバイダーから2番目のプロバイダーを、同じく重みに比例してサンプリングします。
- すべてのプロバイダーが選ばれ、完全な順列ができるまでこれを続けます。
これにより、重みの大きいプロバイダーほどチェーンの前のほうに現れやすく、かつ1つのチェーン内に同じプロバイダーが2回以上現れることはない、フォールバックチェーンの候補空間が得られます。重みが0のプロバイダーは、設定された順序で末尾に追加されます。
プロバイダーの重みの決め方
最初にロードバランシングを実装したときは、キャパシティについての理解とプロバイダーの好みに基づいて、プロバイダーの重みを手動で設定していました。しかし実際には、これを維持するのは大変な手間でした。
プロバイダーによってトークンの計測方法は異なります。キャッシュされたトークンをレート制限に含めるところもあれば、含めないところもあるため、公表されている制限を直接比較するのは困難です。さらに、プロバイダーのキャパシティは一定ではありません。インシデントは発生しますし、レート制限も変わり、実効スループットはトラフィックのパターンによって変動します。
プロバイダーがエラーを返し始めると、送るトラフィックを減らすために手動で重みを下げなければなりませんでした。状況が改善すれば、また調整し直す必要があります。Lovableには時間を使うべきもっと大切なことがあるため、これを自動化することにしました。
時間とお金を奪っている明確な課題があったので、うまくいかなければいつでも取り除けると割り切ったうえで、動的な解決策を構築しました。
重みを手作業で管理する代わりに、データに基づいて自動的に調整するという計画です。実際には、これは2つのステップで構成されます:
- PIDコントローラーを使って、各プロバイダーの可用性を継続的に算出します。PIDコントローラーは、直近のリクエスト結果をもとに割り当てを調整します。これにより、ある時点でプロバイダーが私たちのトラフィックのどれだけを処理できるかを推定できます。
- その可用性を使って重みを算出します。このステップでは、プロバイダーの優先順位を計算に組み込みます。
プロバイダーの可用性の算出
プロバイダーのキャパシティを継続的に評価するため、各プロバイダーに可用性という値を割り当てます。初期値は1で、プロバイダーが正常であることを表します。30秒ごとに、直近のトラフィックに基づいて各プロバイダーのスコアを計算します:
score = (number of successful responses) - 200 × (number of errors) + 1
次に、PIDコントローラーを使い、このスコアを0付近に保つようにプロバイダーの可用性を調整します。係数200は、エラー率約0.5%という目標値に対応しています。
- スコアが負の場合(おおよそエラー率が0.5%を超えた場合)、可用性を下げて、そのプロバイダーが受け取るトラフィックを減らします。
- スコアが正の場合、可用性を上げて、そのプロバイダーが受け取るトラフィックを増やします。
- そのプロバイダーをまったく使わなかった場合は、バイアス(+ 1の部分)によって可用性がわずかに上がります。これにより、以前に失敗したプロバイダーであっても、永遠に見放してしまうことを防ぎます。
- 可用性は[0, 1]の範囲に制限します。
可用性からプロバイダーの重みを算出する
ある時点ですべてのプロバイダーの可用性を合計すると、1を超えることがよくあります。これは単に、全体として見ればプロバイダーが現在のトラフィック以上を処理できるということです。これが柔軟性をもたらします。重みの合計は1であればよいので、どのキャパシティを最大限に使い、どれを使い切らずにおくかを選べるのです。
私たちはプロバイダーの優先順位(観測された速度、モデルの挙動、運用上の要件などから、理想的にはこの順にトラフィックを送りたいという順序)をもとに、次のように重みを計算します:
- 優先順位で1番目のプロバイダーの重みは、その時点の可用性とします。
- 2番目のプロバイダーの重みは、その時点の可用性と「1 -(1番目のプロバイダーの重み)」のうち小さいほうとします。
- 3番目のプロバイダーの重みは、その時点の可用性と「1 -(それまでのプロバイダーの重みの合計)」のうち小さいほうとします。
- 以降も同様です。
こうすることで優先度の高いプロバイダーが優遇され、他のプロバイダーがキャパシティの上限に達したときには、優先度の低いプロバイダーが第一候補としてトラフィックを受け取ります。
可用性の合計が1未満の場合は、合計が1になるよう重みを比例的にスケールアップします。すべての可用性が0の場合は、均等な重みを使います。これによりリクエストは流れ続けますが、キャパシティが生まれるわけではありません。需要がプロバイダーの処理能力を上回れば、エラーが返されることもあります。
これらの重みを使ってフォールバックの順列をサンプリングし、その順列をプロジェクトに対してキャッシュします。その後の数分間、そのプロジェクトは同じフォールバックチェーンを使い続けるため、ターンをまたいでプロンプトキャッシュが維持されます。
まとめ
ここで紹介したシステムは、かなり具体的な制約から生まれました。複数のLLMプロバイダーにトラフィックを分散させる必要があり、その際にはプロバイダーごとの優先度と、各プロバイダーの変動するキャパシティの両方を考慮しなければなりません。しかも、同じプロジェクトでプロバイダーが頻繁に切り替わらないようにする必要がありました。
プロジェクト単位のアフィニティを備えた複数のフォールバックチェーンを使うことで、プロンプトキャッシュの利点を維持できます。また、リアルタイムのトラフィックに基づいてプロバイダーの重みを自動的に調整することで、優先するプロバイダーのキャパシティを最大限に活用しつつ、エラーが発生した際にはスムーズに負荷を減らせます。実際の運用では、手動での調整が少なくて済み、プロバイダー側で起きる問題の一部については、その間もリクエストを処理し続けられるようになりました。
これは、Lovableで日々取り組んでいるインフラの課題のほんの一例です。個人的には、プロバイダーで障害が発生した際に、誰も介入することなくシステムがスムーズにトラフィックを再配分する様子を目にしたときは、本当に大きな達成感がありました。
ロードバランサーの挙動をより分かりやすく確認できるよう、Lovable自体を使ってシミュレーターアプリを構築しました。プロバイダーのキャパシティや障害シナリオを試しながら、フォールバックチェーン、重み、スティッキネスが時間の経過とともにどのように相互作用するかを確認できます。
このようなシステムの構築にワクワクする方は、ぜひご連絡ください。私たちは少人数でスピード感のあるチームで、エンジニアが問題の特定から本番環境への修正のリリースまで、課題をエンドツーエンドで担当しています。たとえば、プロバイダーの応答が通常より遅くなった際にトラフィックを自動的に別のプロバイダーへ振り分けるなど、まだまだ解決すべき課題がたくさんあります。ぜひ募集中のポジションをご覧ください。