今年の1月にLovableに入社しました。それ以前は、コーディング作業に使うトークンは月に$600程度でした。ここで働き始めてからは、担当範囲が広がり、プロジェクトの規模も大きくなり、さらに問題に応じて必要なだけトークンを使える自由もあって、個人の支出は5月に月約$25K、1月からの累計では約$85Kに達しました。多くの人よりも踏み込んで使ってみた結果何が起きたのか、そしてその過程で学んだことを紹介します。
開発プロセス
2026年1月の時点で、私のエージェント型コーディングのプロセスは、プランモード、権限リクエスト、そして従来型のコードレビューで構成されていました。生産的な週といえば、マージされたPRが20〜30件でした。
6月現在では、他のエージェント向けにタスクを書く専用のエージェントがいて、その下で実装エージェントとレビューエージェントが複数の階層で動いています。大きな変更では、作業単位は単一のPRではなく、10個のPRからなるスタックです。人間によるレビューは重要な意思決定に対して行い、コードそのものに対して行うことはほとんどありません。今では、生産的な週といえばマージされたPRが150件以上です。
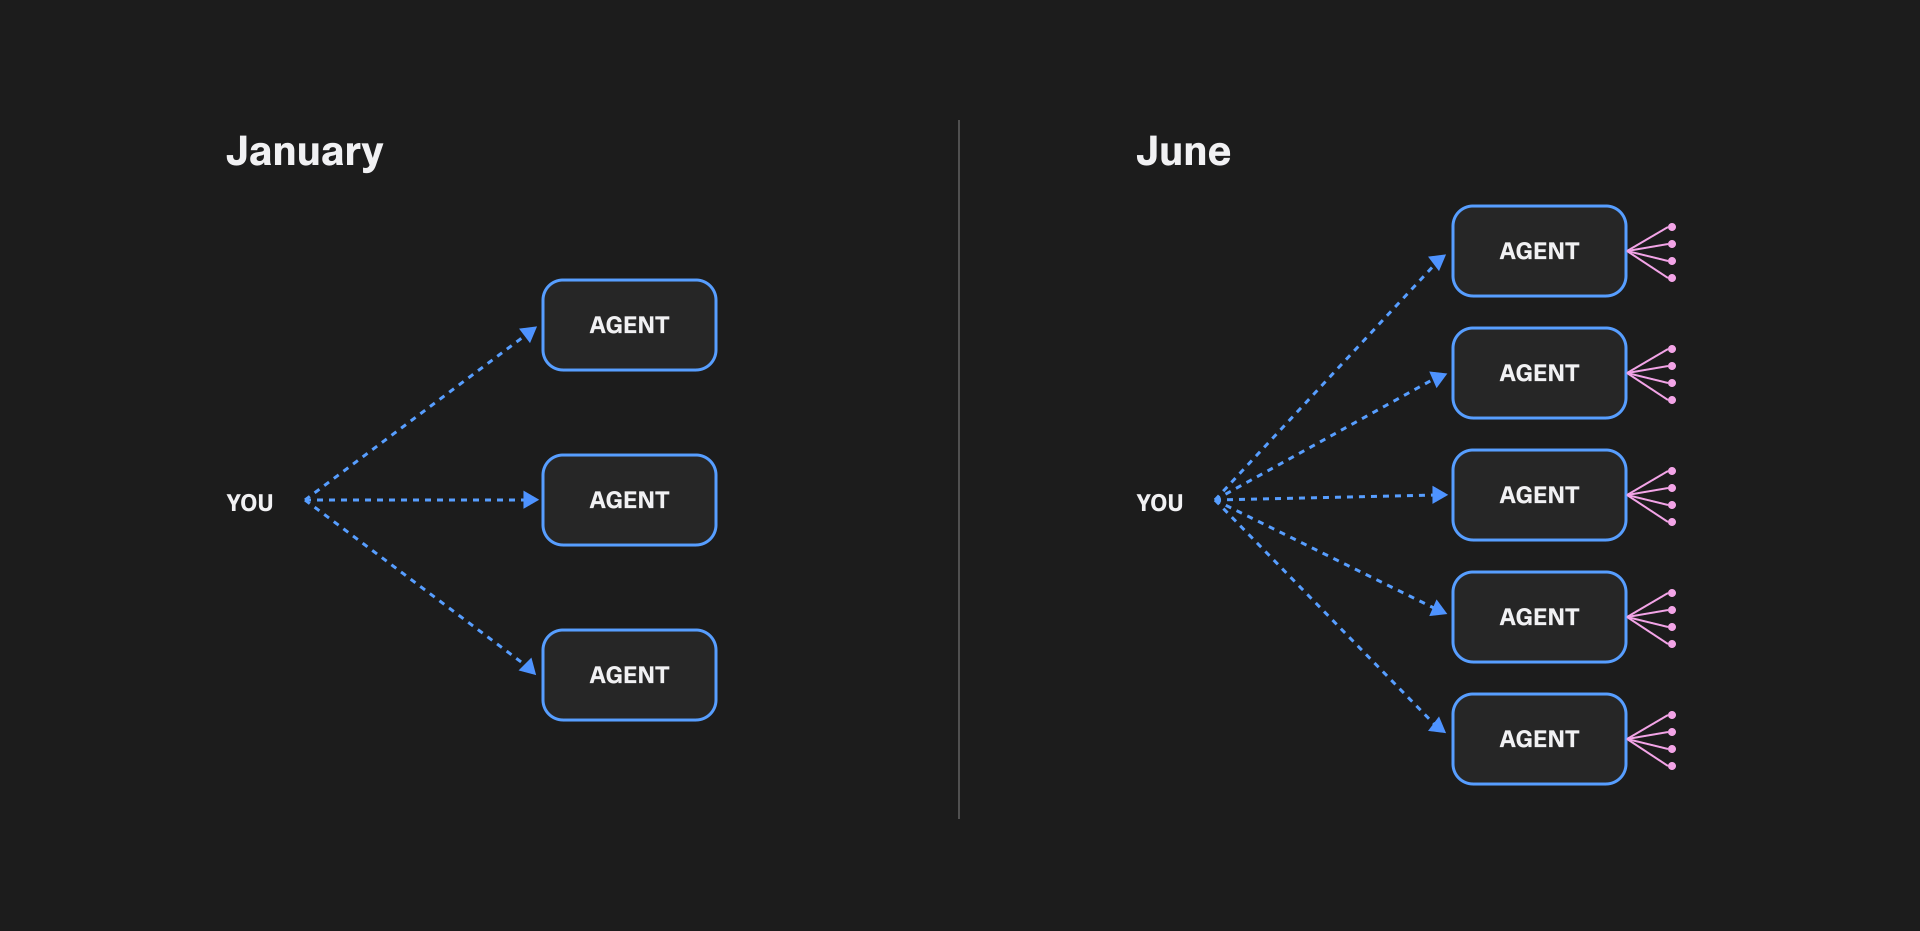
1月:開発者1人と数体のエージェント。6月:1人の人間が6〜7体のエージェントを統括し、それぞれのエージェントが独自のサブエージェントのスウォームを持つ。
支出の内訳
トークンの約75%は実装に直接使っています。残りの25%(さらに増加中)は、あらゆる形の自動化に使っています。開発環境の外で行うAIレビュー、マージ後のAIレビュー、そして定期的に実行されるさまざまな自動タスクです。コード作成のPRループから外れる作業がますます増えるにつれ、この割合は今後も増える一方だと予想しています。
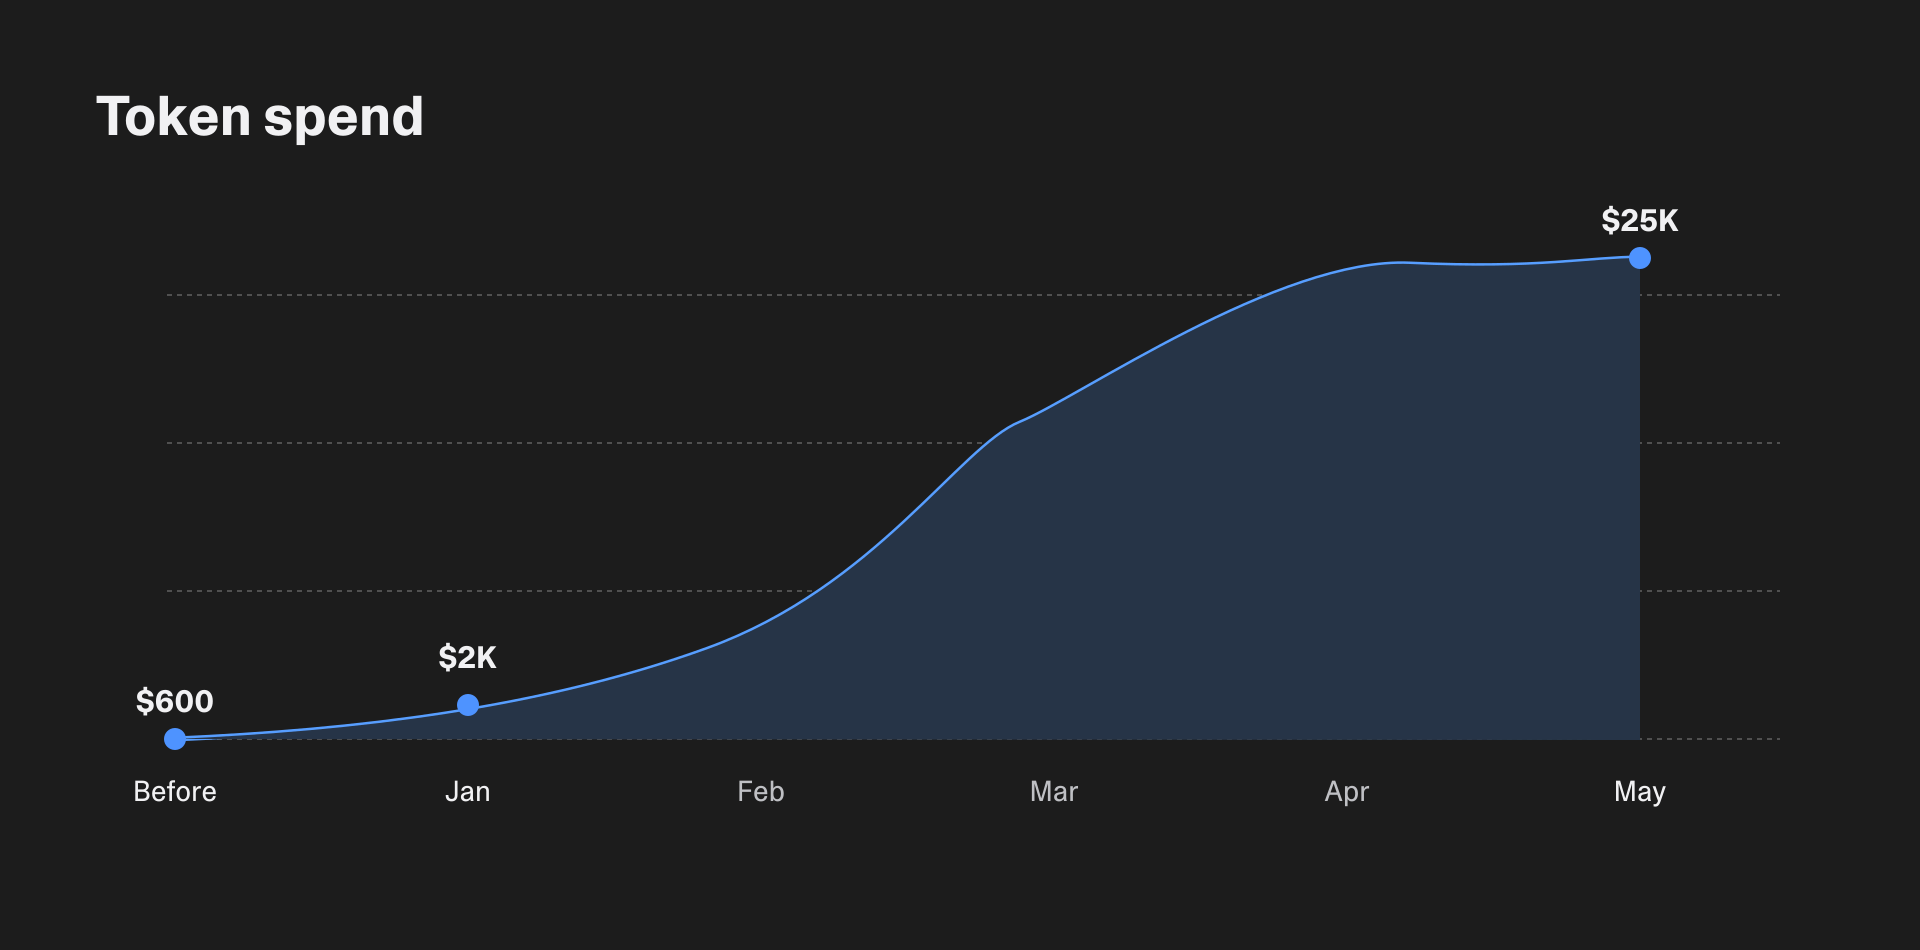
人間によるレビューは例外
人間が書くコードからAIが書くコードへの移行は、多くの意味で新たな抽象化のレベルであり、アセンブリから高水準言語への移行に似ています。当時、人々はかなり早い段階でコンパイラの出力を直接見ることをやめました。今、コードレビューでも同じことが起きています。AIが書いたコードを1行ずつレビューするのは現実的ではなく、誰にとっても時間の有効な使い方ではありません。そして、AIの利用によって生じた問題に対する定番の答えは、さらにAIを使うことです。そのため、デフォルトでAIレビューに切り替えることになります。AIレビューは時間とともに目に見えて良くなっています。
Lovableでうまくいっているのは、人間によるレビューを最も影響の大きい変更に限定するやり方です。ただし、これはPRに対する従来型のコードレビューという形を取らないことがよくあります。代わりに、RFCやADRを使って、より上位のレベルで行われています。難しい問題をペアでデバッグしたり、新しい取り組みについて認識を合わせるために対面でホワイトボードセッションを行ったりすることもよくあります。重要なのは、最も効果が大きいところに人間の注意を向けることです。たとえば、システム設計やインフラの選択についての1回の議論が、50件の実装PRよりもシステムを大きく変えることもあります。だからこそ、私たちは人間の注意を最も重要なところへ移そうとしています。そしてそれは、コードレビューではありません。
問題は、コードレビューがなくなると、変更を1行ずつ承認することとは無関係な副次的メリットの多くも失われてしまうことです。コードレビューはかつて学びの手段であり、組織の中に知識が広がっていく経路でもありました。また、スタイルやアーキテクチャの選択について自然と気づき、認識をそろえる仕組みでもありました。エンジニアリングという分野として、コードレビューの大部分が自動化された世界でも、こうした二次的な効果を維持する方法を見つける必要があります。今のところ良い解決策は見当たらず、新しい実験の余地があるだけです。
変更のリスク分類
ほとんどのPRで人間のレビューを省くと、別の疑問が生まれます。新しく入ったメンバーが入社して数日のうちに本番環境へ何かを出荷することが期待されるような大規模な組織でも、これをスケールできるのでしょうか。結論から言うと、少なくとも素朴なやり方ではできません。システムは、善意にあふれ意欲的でありながら、自分が何を知らないかを知らない可能性のある開発者に対して、ある程度の耐性を備えている必要があります。最終的に私は、PRをリスクレベルごとに分類するAIワークフローを構築し、高リスクのPRには人間によるレビューを強制することで、全体のリスクを妥当な水準に保つことにしました。
つまり、本番環境を壊すリスクが異常に高い変更と、異常に低い変更を見分ける必要があります。では、変更をどう分類すればよいのでしょうか。常識とLLMベースの分類器を組み合わせれば、かなりのところまで行けます。インフラや認証に関係するか? それなら常に高リスクです。ブログ記事の公開か? 低リスクです。大きすぎないか? 変更を含むコードの大部分を作成者のチームが所有しているか? 本番向けの機能か、それとも実験的なものか? といった具合です。
私たちの分類器の中核は、1つのMarkdownのポリシーファイルです。エージェントはこれをPRの差分やメタデータと一緒に読み込み、個々のPRがサイズ、リスクレベル、コードの所有権の観点でどこに位置するかを判断します。その後、分類結果に基づいてポリシーを適用する、大規模ながら地味な決定論的ツールがあり、さらにGitHubのアクションとルールセットのつなぎ込みによって、プルリクエストを現在の状態でマージできるかどうかを許可・拒否します。もちろん、これはすべてAIが生成したものです。適用したいポリシーさえ決まれば、それを中心にシステムを設計するのは、ほぼ解決済みの問題です。
このようなリスク評価を自動化すれば、高リスクの変更には人間のレビュー、中リスクの変更には時間もコストもかかるAIレビュー、低リスクの変更には素早く手軽なAIレビューを求めることができます。そして、レビューでのやり取りのうち、議論が最も大きなメリットをもたらす変更をめぐるものの割合が、ますます大きくなっていきます。
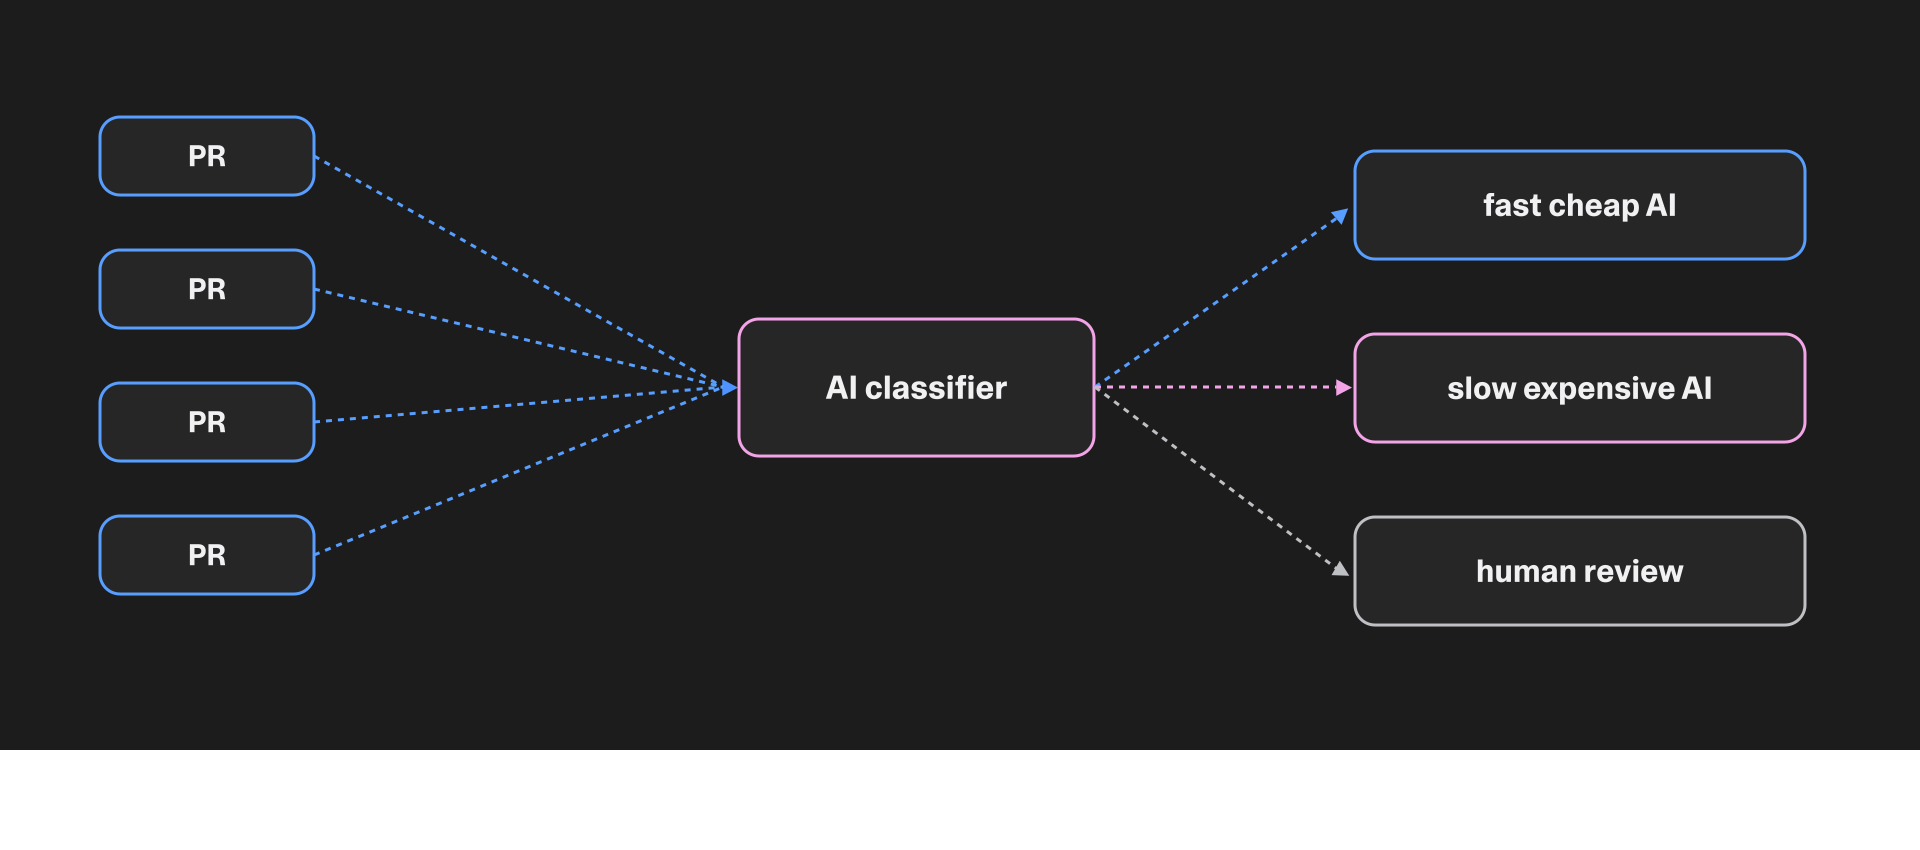
分類器に入ったPRが3つのレーンに分かれる様子:高速なAIレビュー、低速なAIレビュー、そしてエスカレーションが必要な場合の人間によるレビュー。
AIコードレビューのさまざまな形
Lovableに来てから、PR上で動作するAIレビューツールを少なくとも3つ、さらに開発環境でローカルに動作するものをいくつか試してきました。
CIでのレビューのトレードオフは...なかなか興味深いものです。速くて安いものを選ぶと、エージェントが見当違いなことを言ったり、重要な点を見落としたりする可能性がかなりあります。逆に、高価で時間がかかる(1回のパスで30分も珍しくありません)ものは、たいてい正確です。数か月前の時点で、低速で高価なタイプのAIレビューは、平均的な人間のレビューよりすでに役に立つと感じていました。しかも、エージェントは進化し続けています。
ローカルでのレビューもあります。「このコードをレビューして」というシンプルなプロンプトの場合もあれば、サブエージェントや指摘事項のトラッカーなど、さまざまな機能を備えた高度なスキルに発展することもあります。
ここでの最大の効果は、CIのチェックに頼るのではなく、そもそもローカルでレビューを行うこと自体にあります。次に大きな改善は、特定の観点(正確性、パフォーマンス、コードの再利用など)のレビューを複数のサブエージェントに任せ、メインエージェントにそれらの指摘を集約・重複排除させることです。私たちは、良いコードとはどういうものかをエージェントと共有することに多くの労力を注いでいます(スキル、AGENTS.md、コードの隣に置くスタイルガイドなどを通じて)。そのうえで、各自がこの知識を使ってローカルレビューをどう実行するかを独自に試しています。
すぐに気づいたのは、ローカルレビューの指摘に私が異論を唱えることはめったにないということです。そこで自然な次のステップとして、私のレビュー用スキルでは、指摘のトリアージと修正まで、すべて自律的に行うようにしました。発見と指摘の評価を分けることで、各エージェントが自分の役割に集中できるため、全体のパフォーマンスが向上します。興味深いことに、該当する指摘の修正には専用のコンテキストは必要ありません。指摘をうまく評価できるエージェントは、うまく修正することもできるのです。
提案された変更が間違っている場合、私は特定の実行結果を直すためにエージェントと格闘するより、根本原因を見つけて直すほうを選びます。エージェントが間違うのはたいていコンテキストが足りないときで、ナレッジファイルやスタイルガイドなどを改善することで解決できます。
AIレビューは両方の種類を導入しておくべきだと思います。CIでのレビューは共通の土台であり、セーフティネットです。ローカルでのレビューと修正の仕組みこそが本当の主力で、生産的な作業の大部分を担ってくれることが期待されます。ただし、この仕組みを人の間でどう共有するのが最善かは、まだ解決されていない課題です。
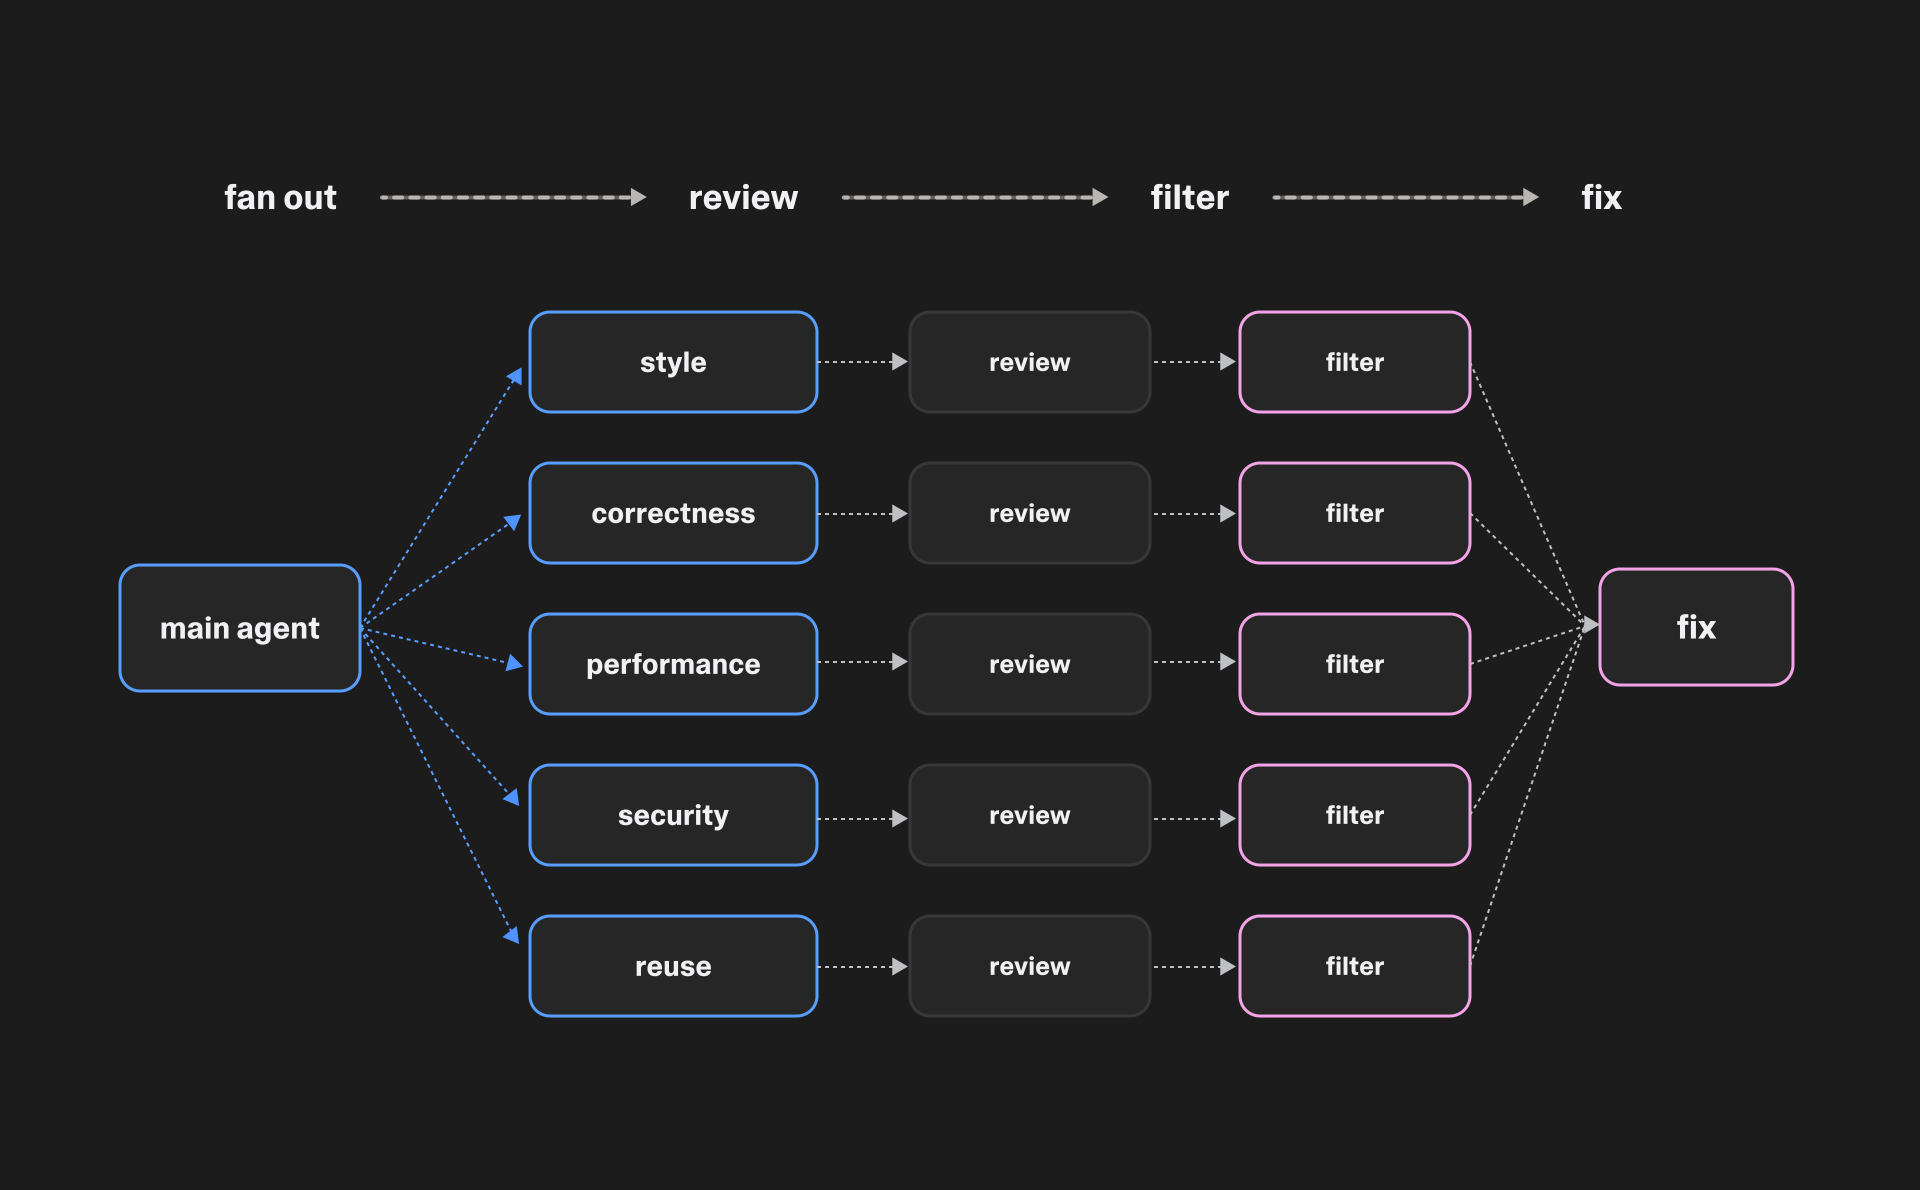
メインエージェントが正確性、パフォーマンス、再利用、セキュリティを担当するサブエージェントに作業を割り振り、指摘を集約して修正する様子。
PRはエージェントの時代を生き残るのか?
AIコーディングの時代にはPRは時代遅れになる、という主張を目にしました。また、スタックPRが意味を持つのは人間のレビューに頼る場合だけだ、とも。現時点では、私はどちらの主張にも同意しません。
PRは、未検証の変更を扱うための優れた抽象化です。CI/CDはPRを単位に動きます。マージ前のテスト環境もほとんどがPRを単位に動きます。ほかにどうやって変更を検証するのでしょうか。「自分のマシンでは動きます」とでも? ですから、PRを取り巻くプロセスが大きく変わったとしても、PRは有用な抽象化であり続けるのかもしれません。ファイルシステムとその基本的な抽象化が、今日とはまったく異なるハードウェア向けにUNIXが開発したものにまでさかのぼれることと比べてみてください。
スタックPRについては、コンテキスト管理とリスク管理の両面で非常に役立つと感じています。変更が一定以上大きくなると、AIコードレビューの品質は急激に低下します。以前、私のチームの開発者が、6,000行の大きなPRでAIレビューの承認を得たことがありました。私はそのPRをスタックに分割するよう頼みました。分割してみると、同じAIレビュアーが、分割後の小さなPRで実際の問題を新たに見つけ始めたのです。この一件以来、Lovableのエンジニアは大きなPRをますます信用しなくなりました。大きなPRはもともと人間にはレビューできませんでしたが、AIにもレビューできないことがわかったのです。いつかモデルの進歩によって変わるかもしれませんが、まだその段階には至っていません。
自分自身の注意をどう管理するか
無制限にコードを生み出す魔法の認知マシンがあると、頭の中のコンテキストスイッチが、全体の生産性を左右する厳しい制約のひとつになります。ここでは、スケールさせるための考えをいくつか紹介します。
高速モードは非常にお得です。対話的にやり取りするセッションでは、使う意味が大いにあります。たとえば私は、計画は必ず高速モードで立てるようにしています。5つの対話セッションを並行して進めようとするよりも、はるかに生産的です。とはいえ、非対話的なタスクで高速モードを使う理由はないと考えています。たとえば、夜間に実行するタスクが午前5時ではなく午前3時に終わっても、何の価値もありません。また日中は、一度に最も重要なことひとつに集中したいものです。ほかのタスクはバックグラウンドでゆっくり進めればかまいません。
タスクの自律性が鍵です。エージェントには、可能な限り長くタスクを進められるだけのコンテキストとツールが必要です。オートモードやYOLOモードのようなものは必須で、権限リクエストはゼロにしたいところです。そのため、通常はリスクのある操作をエージェントが安全に実行できるよう、専用のツールを追加したくなることもあります。たとえば、私のエージェントはgh CLIでPRをマージすることは許可されていませんが、ブランチが最新であることや、未解決のPRディスカッションがないことなどに関する追加の安全策付きで、Graphiteの「merge when ready」を使うことは許可されています。さらにgt CLIの呼び出しは、ユニットテストでカバーされたカスタムのNode.jsスクリプトでラップしており、エージェントがミスをする余地がないようにしています。これらはすべてエージェントのスキルとして書き下ろしてあります。すべてを整えるのはかなりの手間でしたが、不適切なマージを二度と修正しなくて済むことで、その労力は十分に報われています。
エージェントが正しいものを作ったかどうかを検証したいと考えています。安全な範囲で、できるだけ多くの検証作業をエージェントに任せたいと思っています。すべてを任せられることもあれば、人間が関与する必要があることもあります。理想は、検証作業をまとめて、PRスタックごとにちょうど1回だけ行うことです。これは通常、PRスタックの最上部で最終結果を検証し、スタック内の中間のPRを1つずつ検証する必要がないようにすることを意味します。つまり、個別にマージしても安全なアトミックなPRを、プロセスがデフォルトで生み出すと確信できなければなりません。そして、例外があればエージェントが必ず知らせてくれることも確信できなければなりません。
エージェントの注意をどう管理するか
エージェントが大きな変更を自律的に構築できるようにするには、サポートが必要です。そのための私のセットアップの主な要素を紹介します。
外部タスクトラッカーとしてのBeads。大きなタスクでは、100万トークンを超えるコンテキストが必要になることがあります。コンテキストウィンドウが大きくなるほど、品質は下がり、コストは増えます。自動コンパクションが手動のコンテキスト管理に十分匹敵するとは思っていません。また、エージェントはときどきクラッシュするので、親方と作業者のやり取りを再現できるような、永続的な引き継ぎの手段がほしいのです。これにはサブエージェントは向いていません。要するに、こうしたことにはある程度永続的なタスク管理の仕組みが必要です。私はBeadsをgitに同期せず、ローカル環境で使っています。ほかのツールでも同じようにうまくいくかもしれません。
サブエージェント。大量のコンテキストを消費する作業や、独自の目標を持つ個別のサブタスクは、サブエージェントに任せています。コードの調査。特定の性質に焦点を当てたコードレビュー。エージェントは委任の機会を見つけて活用するのが上手になってきていますが、今のところは、サブエージェントを決定論的に使う形で普段のワークフローを組み立てるほうがよいでしょう。また、単純なタスクを小さなモデルに任せられれば、コストの節約にもなります。
小さなPR。上でも書きましたが、PRを数十〜数百行のコードに収めることで、実装やレビューの途中でエージェントのコンテキストが足りなくなるのを防げます。スタックPRと推奨されるPRサイズについて(共有スキルを通じて)エージェントに教えてからは、大きなタスクを複数のPRに安定してうまく分割してくれるようになりました。
タスクごとに新しいコンテキスト。個人的には基本中の基本だと思いますが、複数のタスクでコンテキストを使い回すべきではありません。/clearは無料で、元に戻すこともでき、入力にほんの数秒しかかかりません。
補足:タスク管理
ここで私が強く信じているのは、人間向けのタスク管理とエージェント向けのタスク管理は分けるべきだということです。エージェントの思考の連鎖がびっしりと書き込まれたLinearのチケットを見たことがありますが、見られたものではありませんでした。エージェントが生成するテキストのほとんどは一時的なもので、そのように扱うべきです。つまり、ユーザーごとにとどめ、ほかの人には決して見せないということです。Linearへの書き込みを意図的に行うようにすれば、そこに質の低いテキストがあふれることも減るでしょう。
自らを構築する工場
開発プロセスはどう改善すればよいのでしょうか。ボトルネックを見つけ、そこでのスループットを高める方法をじっくり考え、そのアイデアを適用し、このループを繰り返すのです。
これについて、いくつか気づいたことがあります。
エージェントはスキルを書くのが得意です。私が最後に手作業でスキルを書いたのは、たしか1月だったと思います。エージェントに頼んでみて以来、もう手作業に戻ることはありませんでした。繰り返し行うワークフローはすべてスキルにして、スキルを頻繁に改善してみてください。おすすめのコツは、タスクの最後にスキルの改善アイデアをエージェントに尋ねることです。Lovableでもすでに、よく似た考え方で自己改善を行っています。エージェントに愚痴をこぼすツールを与えた話をご覧ください。
より長い振り返りも効果があります。私は定期的に「直近でマージした100件のPRを、PRコメントとその対応も含めて見直し、改善点を提案して」といった依頼をしています。すると有用な提案がたくさん返ってくるので、それをエージェントに実装してもらいます。
CI/CDとDevEx(開発者体験)のツールを整えておく必要があります。LovableのDevExチームは、変更量が10倍になってもシステムがスケールし、さらにその先もスケールし続けられるよう、多くの改善を行ってきました。
過去の作業の見直しは宝の山です。エージェントのセッションログをLLMに読み込ませて知見を探すと、毎回何かしら役立つものが得られます。エージェントは小さなつまずきを常に乗り越えていますし、ときには何かが原因で完全に脱線してしまうこともあります。そのすべてが、時間をかけて環境を改善していく自己振り返りループの燃料になり得ます。
コンテキストの共有は簡単です。すべてをgitに入れるだけです。そうすれば、開発チームの全員(とそのエージェント)が、仕組みやコードの書き方などについて、同期された最新の知識を自動的に得られます。AI以前の時代、文書化された知識の恩恵を主に受けていたのはリモートのチームメンバーでしたが、今ではエージェントが主な利用者になっています。つまり、オフィス中心のLovableには、数年前のフルリモート企業以上に、物事を書き残す理由があるということです。
共有することが文化として推奨されています。
スキルの共有は難しいものです。エージェントによる開発のベストな進め方をどう共有するかは、いまだにほとんど解決されていない課題です。開発ワークフローの工夫を紹介し合うSlackチャンネルがあり、ときどきデモセッションも開かれ、隣同士で働いていれば自然と知識の交換も起こります。それでも、これまでのワークフローや手法を同僚に伝えるよりも速いペースで、新しいものを生み出しているように感じます。
それだけの価値はあるのか?
6月の第1週、私は293件のPRをマージしましたが、今のところそれらの変更に起因する本番環境の不具合は見つかっていません。後者については少し運が良かった面もあります。この量であれば、軽微な不具合が2〜3件、重大な不具合が1件あっても許容範囲だと考えています。
それだけの価値はあったのでしょうか。今の私の生産性は、AIの支援を受けない従来の開発手法ではとうてい到達できない水準です。その意味で、もう後戻りはできないと感じています。
開発者をそれに見合う人数だけ増やすよりも良いのでしょうか。これはバランスを取るのが難しい問題で、それぞれの組織が独自の均衡点にたどり着くことになるでしょう。
トークンにお金をかけるもっと良い方法はあるのでしょうか。まず、トークンマキシング(トークン消費量をひたすら増やすこと)は愚かで近視眼的な行動です。明確な目的を持つ必要があります。最終的に重要なのは成果であり、そこに至るまでにどれだけ作業したかではありません。また、コスト効率に向ける注意の最適な量はゼロではありません。今の私たちにとっては5%くらいでしょうか。残りの95%は、より多くのトークンを投入して、より多くの課題を解決する新しく優れた方法を見つけることに向けるべきです。モデルの能力は非常に速く進化しており、探索すべき領域は私たちが探索できるスピードよりも速く広がっています。探索を減らすことの機会損失はあまりに大きく、トークン効率に注意の10%を割くことさえ正当化しにくいと感じています。
全体として、ここまで驚くほど楽しい道のりでした。この先に何が待っているのか、楽しみでなりません。次の$85Kのトークンは、私たちのプロダクトをより良くする新しい方法を見つけることに使われるでしょう。これまで考えられなかったほどの量のソフトウェアを素早く生み出せるようになったとき、その力で何をしますか?
興味を持っていただけたなら、Lovableでは採用を行っています。